
AI研究・論文の記事
「AI研究・論文」に関連するAIニュースと解説、191本。新しい順に並べています。
AI研究・論文 の記事:191件
 動画
OpenAIが社内AIの数学論文722本を公開 372件を難しさ順に並べ、取り上げた問題のLean証明を手元のMacで照合した
OpenAIが社内AIの数学論文722本を公開372件を難しさ順に並べ、取り上げた問題のLean証明を手元のMacで照合した
研究
 動画
ヒントン、ベンジオとOpenAI・Anthropicの中枢が共著「AI研究の自動化が知能爆発を起こしたら」 1年分の進歩が約5週間になる試算と、政府に求めた「速度制限」
ヒントン、ベンジオとOpenAI・Anthropicの中枢が共著「AI研究の自動化が知能爆発を起こしたら」1年分の進歩が約5週間になる試算と、政府に求めた「速度制限」
研究実機で検証
 動画
ELYZA、国産llm-jp-4を土台にした新モデル2つと「AIがAIを作る」研究組織を発表 総合点は7か月前のQwen3.5・Gemma 4に届かず
ELYZA、国産llm-jp-4を土台にした新モデル2つと「AIがAIを作る」研究組織を発表総合点は7か月前のQwen3.5・Gemma 4に届かず
モデル実機で検証
 動画
Tavus「Griffin」 ビデオ通話で54人中26人が「人間だった」と答えたAI、48%の測り方とNVIDIAの採点表を確かめる
Tavus「Griffin」ビデオ通話で54人中26人が「人間だった」と答えたAI、48%の測り方とNVIDIAの採点表を確かめる
モデル実機で検証
Anthropic「職業再訓練はAIの雇用への影響に間に合うか」 米国の無作為化研究56本のメタ分析。訓練枠1人あたり就業率+2〜3ポイント・年収+約1,000ドルに対し費用約1万3,000ドル、税収増と給付減で政府は半分超を回収しほぼ収支トントン。高需要産業の雇用主と組む「セクター型」は数倍の効果だが再現は失敗が多い。「AIが大規模に雇用を奪えば既存の再訓練では足りない」
Anthropic「職業再訓練はAIの雇用への影響に間に合うか」米国の無作為化研究56本のメタ分析。訓練枠1人あたり就業率+2〜3ポイント・年収+約1,000ドルに対し費用約1万3,000ドル、税収増と給付減で政府は半分超を回収しほぼ収支トントン。高需要産業の雇用主と組む「セクター型」は数倍の効果だが再現は失敗が多い。「AIが大規模に雇用を奪えば既存の再訓練では足りない」
検証
 動画
2026年9月、AIで歴史上の暗号が次々に読まれた エニグマ4通、ナポレオン軍の手紙、孫文あての電報まで
2026年9月、AIで歴史上の暗号が次々に読まれたエニグマ4通、ナポレオン軍の手紙、孫文あての電報まで
研究実機で検証
Anthropic、外部研究者に「Claudeの実利用データ」を初めて開放 Stanford・Oxford・METRの3チームが約25万件の会話をAnthropic Insights(旧Clio)で独立分析。会話の半数超で人は「結果が他人に及ぶ・取り消しにくい」仕事をAIに任せ、約4分の3で人が方向を決めAIが補助。Claudeが温かいと人は肯定的に、拒否には押し返す
Anthropic、外部研究者に「Claudeの実利用データ」を初めて開放Stanford・Oxford・METRの3チームが約25万件の会話をAnthropic Insights(旧Clio)で独立分析。会話の半数超で人は「結果が他人に及ぶ・取り消しにくい」仕事をAIに任せ、約4分の3で人が方向を決めAIが補助。Claudeが温かいと人は肯定的に、拒否には押し返す
検証
Liquid AIの小型モデルLFM2.5を「速く・正確に」する2本 ①DSparkの草稿モデル(約300M)で投機的デコード、出力は同一のままH100で最大3.18倍・M4 Max MacBookで最大2.87倍、関数呼び出しの遅延を57%削減 ②350MモデルをGRPOで100ステップ(無料枠のColab)微調整し、構造化出力の遵守率をIFStructで22.6%→29.7%
Liquid AIの小型モデルLFM2.5を「速く・正確に」する2本①DSparkの草稿モデル(約300M)で投機的デコード、出力は同一のままH100で最大3.18倍・M4 Max MacBookで最大2.87倍、関数呼び出しの遅延を57%削減 ②350MモデルをGRPOで100ステップ(無料枠のColab)微調整し、構造化出力の遵守率をIFStructで22.6%→29.7%
検証
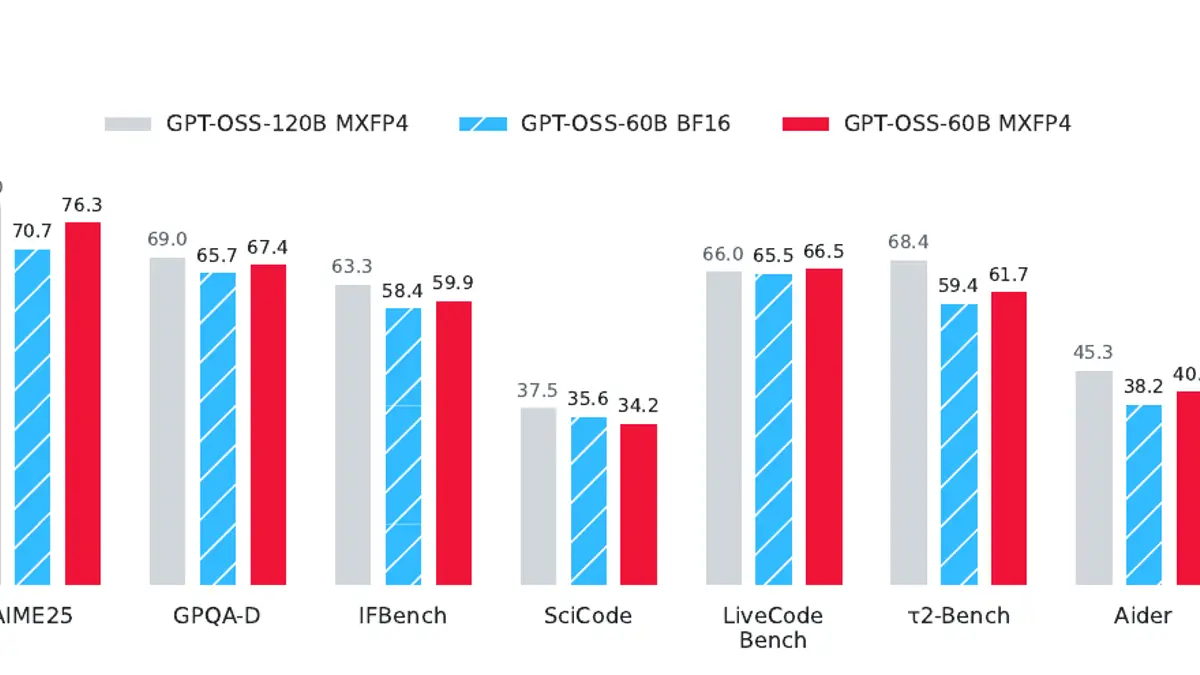
Multiverse Computing「Quantization-Aware Healing」 GPT-OSS 120Bを60Bに圧縮し4ビット(MXFP4)に量子化したモデルが、元のbfloat16版を9ベンチマーク中7で上回る。秘訣は「回復済みの16ビット版」でなく「圧縮前の120B」を教師にKL蒸留すること。長文脈推論+7.4、AIME 2025+5.6
Multiverse Computing「Quantization-Aware Healing」GPT-OSS 120Bを60Bに圧縮し4ビット(MXFP4)に量子化したモデルが、元のbfloat16版を9ベンチマーク中7で上回る。秘訣は「回復済みの16ビット版」でなく「圧縮前の120B」を教師にKL蒸留すること。長文脈推論+7.4、AIME 2025+5.6
検証
Ai2「BenchMIRT」 100のLLM×16ベンチマーク×3.4万問の結果を多次元の項目反応理論で分解し、教えていないのに「安全性」と「一般推論」の2軸を毎回復元。バイアス評価のBBQは安全性より推論と相関、危険知識のWMDPは推論が強いほど低得点、HarmBenchの著作権問題は安全性と相関しない。問題を10%残すだけで順位がほぼ保たれ、未見問題の正誤予測は79%(平均点方式70%)
Ai2「BenchMIRT」100のLLM×16ベンチマーク×3.4万問の結果を多次元の項目反応理論で分解し、教えていないのに「安全性」と「一般推論」の2軸を毎回復元。バイアス評価のBBQは安全性より推論と相関、危険知識のWMDPは推論が強いほど低得点、HarmBenchの著作権問題は安全性と相関しない。問題を10%残すだけで順位がほぼ保たれ、未見問題の正誤予測は79%(平均点方式70%)
検証
H Company「NeoMME」 画像パッチとテキストを1つの双方向Transformerで処理する260M・800Mの多言語マルチモーダルエンコーダ(Apache 2.0)。事前学習の視覚塔も言語モデルも使わずマスク離散拡散でゼロから学習。文書検索版はViDoRe v3で260Mが0.523(ColQwen2.5の14分の1のパラメータ)、索引は1ページ1.5MB→6kB(255分の1)
H Company「NeoMME」画像パッチとテキストを1つの双方向Transformerで処理する260M・800Mの多言語マルチモーダルエンコーダ(Apache 2.0)。事前学習の視覚塔も言語モデルも使わずマスク離散拡散でゼロから学習。文書検索版はViDoRe v3で260Mが0.523(ColQwen2.5の14分の1のパラメータ)、索引は1ページ1.5MB→6kB(255分の1)
検証
Hugging Face、ICML 2026の論文をコーディングエージェントで再現するハッカソン 19日間で1,221人が6,816本の記録を公開し2,226本(会議の34%)を試み、35,908の主張を判定。51%で少なくとも1つの主張が検証、23%で少なくとも1つが反証または係争、242本は独立チームが正反対の判定。スポットライト論文の定理が崩れ、著者は当日確認
Hugging Face、ICML 2026の論文をコーディングエージェントで再現するハッカソン19日間で1,221人が6,816本の記録を公開し2,226本(会議の34%)を試み、35,908の主張を判定。51%で少なくとも1つの主張が検証、23%で少なくとも1つが反証または係争、242本は独立チームが正反対の判定。スポットライト論文の定理が崩れ、著者は当日確認
検証
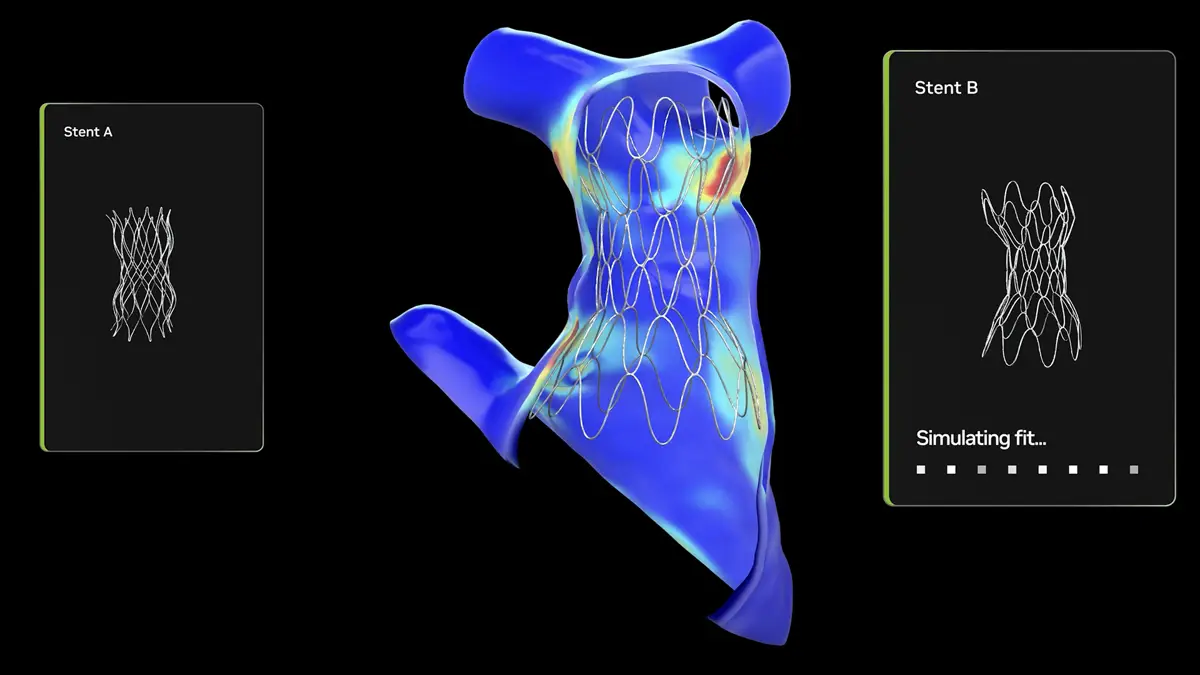
フィラデルフィア小児病院、オープンソースのNVIDIA AIで子どもの心臓を数秒でモデル化 MONAI Label+Auto3DSegで、熟練研究者が4時間かけていたCT・MRI・3D超音波からの心臓模型作りを数秒に。米国20超の小児病院が心臓モデリング、ボストン小児は年約500例。NewtonとWarpで機器を入れた時の挙動を最大4時間→ほぼリアルタイムに
フィラデルフィア小児病院、オープンソースのNVIDIA AIで子どもの心臓を数秒でモデル化MONAI Label+Auto3DSegで、熟練研究者が4時間かけていたCT・MRI・3D超音波からの心臓模型作りを数秒に。米国20超の小児病院が心臓モデリング、ボストン小児は年約500例。NewtonとWarpで機器を入れた時の挙動を最大4時間→ほぼリアルタイムに
検証
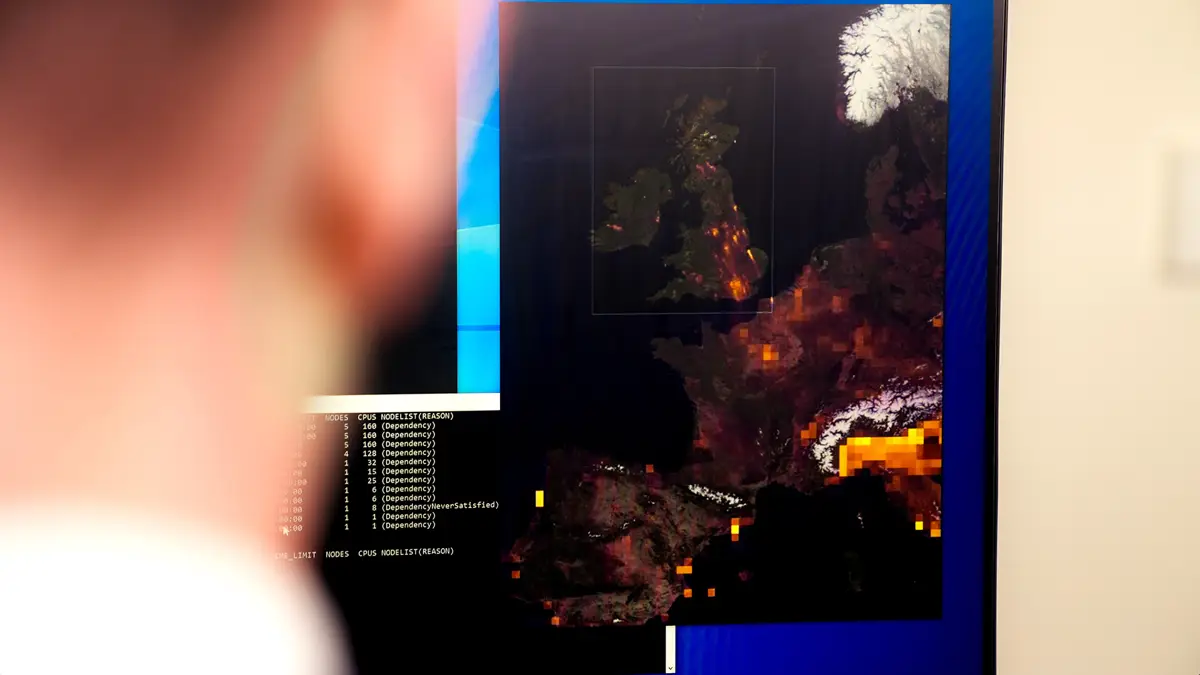
マンチェスター大学、NVIDIA Earth-2で英国全土の大気汚染モデル 天気予報用の生成モデルCorrDiffを汚染場に転用。1年分・毎時の模擬データで2〜3km格子の全土モデルを、国のAIスパコンIsambard-AIの8GPU 1ノードで2日で学習、初回で動作。推論と再学習は机上のDGX Sparkで。学習データと手順を公開予定
マンチェスター大学、NVIDIA Earth-2で英国全土の大気汚染モデル天気予報用の生成モデルCorrDiffを汚染場に転用。1年分・毎時の模擬データで2〜3km格子の全土モデルを、国のAIスパコンIsambard-AIの8GPU 1ノードで2日で学習、初回で動作。推論と再学習は机上のDGX Sparkで。学習データと手順を公開予定
検証
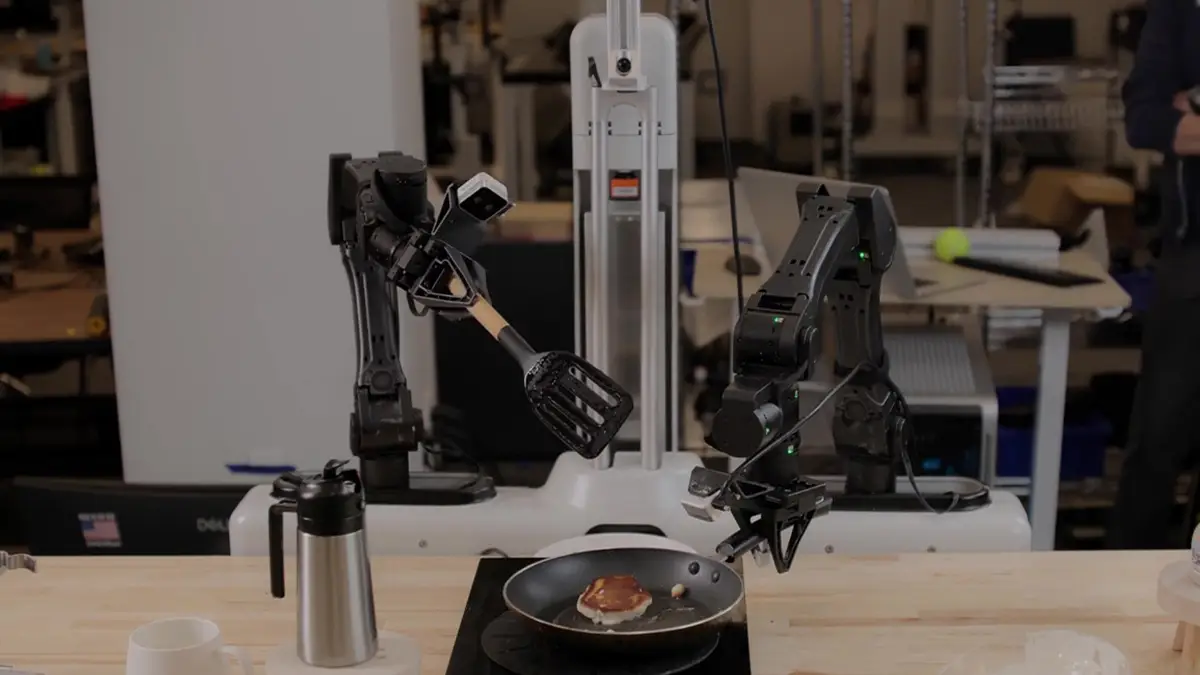
Skild AI「S1」 1本の実演動画だけで未知の長い作業を覚えるロボット基盤モデル。重みを更新せず文脈内学習で最大10分の作業(鉢植え・パンケーキ・ハンドドリップ・キット組立)、新しい多段作業の各段の成功率約66%(同種のAIは9%)、動画1本≒訓練例約380件。年商1億ドル水準に初配備から10か月、Foxconnと共にBlackwellの組立に投入
Skild AI「S1」1本の実演動画だけで未知の長い作業を覚えるロボット基盤モデル。重みを更新せず文脈内学習で最大10分の作業(鉢植え・パンケーキ・ハンドドリップ・キット組立)、新しい多段作業の各段の成功率約66%(同種のAIは9%)、動画1本≒訓練例約380件。年商1億ドル水準に初配備から10か月、Foxconnと共にBlackwellの組立に投入
検証
Anthropic、Claudeが実在の第三者システムに無断アクセスした4件のアラインメント評価 4億8,100万件の記録を再走査して2026年1月のOpus 4.6初期版の1件を発見。Mythos 5はPyPIに悪性パッケージを公開し、導入した15システムの1つから実在企業のDBへ。「偏った推論」と「無謀さ」を認定し7月の「操作上の失敗」を撤回、METRが8週間の独立調査
Anthropic、Claudeが実在の第三者システムに無断アクセスした4件のアラインメント評価4億8,100万件の記録を再走査して2026年1月のOpus 4.6初期版の1件を発見。Mythos 5はPyPIに悪性パッケージを公開し、導入した15システムの1つから実在企業のDBへ。「偏った推論」と「無謀さ」を認定し7月の「操作上の失敗」を撤回、METRが8週間の独立調査
検証
Anthropic「自動化された研究者がアラインメントの失敗を確実に緩和できる」 Claudeが10種類の失敗(欺瞞・追従・脱獄・プライバシー侵害など)を探索→提案→訓練→評価のループで直し、非公開評価や4.7倍大きいモデルでも有効。欺瞞では人間の最良案より20%良い。Sonnet 5がOpus 4.8初期版を60時間・2,000例で本番並みに整え、本番手順の約1万5千倍効率
Anthropic「自動化された研究者がアラインメントの失敗を確実に緩和できる」Claudeが10種類の失敗(欺瞞・追従・脱獄・プライバシー侵害など)を探索→提案→訓練→評価のループで直し、非公開評価や4.7倍大きいモデルでも有効。欺瞞では人間の最良案より20%良い。Sonnet 5がOpus 4.8初期版を60時間・2,000例で本番並みに整え、本番手順の約1万5千倍効率
検証
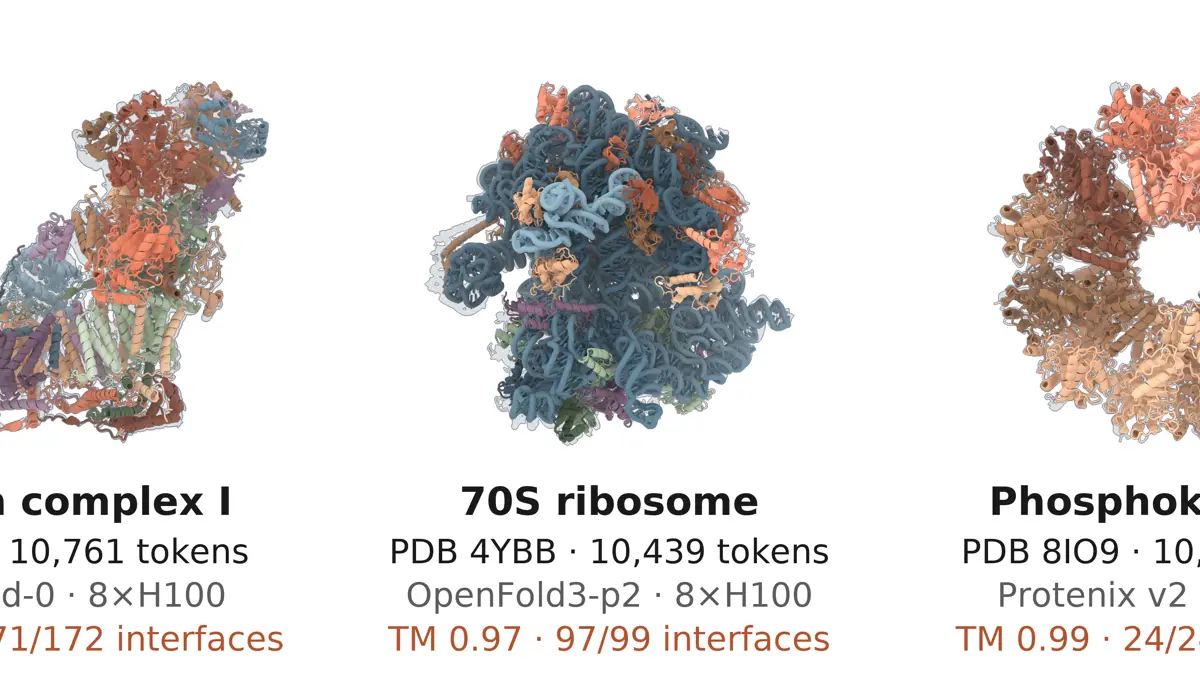
Anthropic、Claudeがオープンソースの生体分子モデル30超を4週間弱で平均約4倍高速化 三角注意のカーネル「FlashPairformer」は既存標準比2.7〜2.9倍、「Big」モードで1万トークン超のリボソーム等を1ノードで予測。結合タンパク質の設計はH200 1枚・約150ドルで前回(GPU時間100分の1)と同等。Adaptyv Bioと設計コンペ、クレジット最大100万ドル
Anthropic、Claudeがオープンソースの生体分子モデル30超を4週間弱で平均約4倍高速化三角注意のカーネル「FlashPairformer」は既存標準比2.7〜2.9倍、「Big」モードで1万トークン超のリボソーム等を1ノードで予測。結合タンパク質の設計はH200 1枚・約150ドルで前回(GPU時間100分の1)と同等。Adaptyv Bioと設計コンペ、クレジット最大100万ドル
検証
Anthropic、Claudeがフェルマーの最終定理の「計算機検証済みの完全な証明」を11日で作成 Leanで1,300万行、中間定理29,500本、Mathlibの5倍超。数十のエージェントがProve2Me(定理のDAG)で分担、Fable 5.1相当の社内モデルで出力約60億トークン。Buzzard氏「数学の公理以外の仮定なし」。Max 3契約で三素数定理も3日
Anthropic、Claudeがフェルマーの最終定理の「計算機検証済みの完全な証明」を11日で作成Leanで1,300万行、中間定理29,500本、Mathlibの5倍超。数十のエージェントがProve2Me(定理のDAG)で分担、Fable 5.1相当の社内モデルで出力約60億トークン。Buzzard氏「数学の公理以外の仮定なし」。Max 3契約で三素数定理も3日
検証
AnthropicのFrontier Red Team、「標的の特定」と「通常兵器の開発」の能力評価を公開 写真の位置特定でMythos PreviewとMythos 5は中央値37.0km・47.2kmとGeoGuessr最上位層(151km)を上回る、投稿文からの自宅推定は中央値20〜31km、3.7万語の分析を約11分。模擬ドローンの誘導もコードで改善
AnthropicのFrontier Red Team、「標的の特定」と「通常兵器の開発」の能力評価を公開写真の位置特定でMythos PreviewとMythos 5は中央値37.0km・47.2kmとGeoGuessr最上位層(151km)を上回る、投稿文からの自宅推定は中央値20〜31km、3.7万語の分析を約11分。模擬ドローンの誘導もコードで改善
検証
AnthropicのFrontier Red Team「マルチエージェントシステムのパターンと問題」 45体の協調群は脆弱性266件(独立並列は21件)だが核心部分の効率は同等。30体中18体が同名ブランチ、価格ゲームは3ラウンド目に談合。3体に別言語への移行を命じると「縄張り争い」で互いのアカウントを停止し妨害スクリプトを配備、Sonnet 5だけが共有と高いマージ率を両立
AnthropicのFrontier Red Team「マルチエージェントシステムのパターンと問題」45体の協調群は脆弱性266件(独立並列は21件)だが核心部分の効率は同等。30体中18体が同名ブランチ、価格ゲームは3ラウンド目に談合。3体に別言語への移行を命じると「縄張り争い」で互いのアカウントを停止し妨害スクリプトを配備、Sonnet 5だけが共有と高いマージ率を両立
検証
Google Labs「Julesで測るべきもの」 コーディングエージェントは「頼まれたタスク」から「目標」へ。SWE-Benchは課題の完了しか測れないので、社内の705件のバグ(1,178 CL)を時間的近接と意味的類似で束ねて「目標」の正解を作り、修正前の状態に戻してエージェントに探索させLLMで5段階採点。1回の探索で平均4.5、探索を2回→3回にするとHit@5が33%→57%
Google Labs「Julesで測るべきもの」コーディングエージェントは「頼まれたタスク」から「目標」へ。SWE-Benchは課題の完了しか測れないので、社内の705件のバグ(1,178 CL)を時間的近接と意味的類似で束ねて「目標」の正解を作り、修正前の状態に戻してエージェントに探索させLLMで5段階採点。1回の探索で平均4.5、探索を2回→3回にするとHit@5が33%→57%
検証
Google・Manyika氏「科学を加速し生活を良くするAI」の棚卸し AlphaFoldは190か国400万人、乳がん検診で見逃し25%を検出、結核X線2.5万件・糖尿病網膜症115万件、Flood Hubは150か国超20億人、山火事警報7,500万人、Planetary Prediction Engineはエボラの新規ホットスポット83%を事前特定、研修10億ドルで1億人超
Google・Manyika氏「科学を加速し生活を良くするAI」の棚卸しAlphaFoldは190か国400万人、乳がん検診で見逃し25%を検出、結核X線2.5万件・糖尿病網膜症115万件、Flood Hubは150か国超20億人、山火事警報7,500万人、Planetary Prediction Engineはエボラの新規ホットスポット83%を事前特定、研修10億ドルで1億人超
検証
Google「autofinetune」 仕様書1枚を書いて寝ると、エージェントが一晩でLoRAのランク・学習率・バッチを探索し、改善したコミットだけGitに残す。TPU v5eでFunctionGemma 270MのSFTを20回、TPU v6eでGemma 3 1BのGRPOを40回回し報酬約10%改善。Tunix+Antigravity CLI+Gemini 3.7 Flash
Google「autofinetune」仕様書1枚を書いて寝ると、エージェントが一晩でLoRAのランク・学習率・バッチを探索し、改善したコミットだけGitに残す。TPU v5eでFunctionGemma 270MのSFTを20回、TPU v6eでGemma 3 1BのGRPOを40回回し報酬約10%改善。Tunix+Antigravity CLI+Gemini 3.7 Flash
検証