
大規模言語モデル(LLM)の記事
「大規模言語モデル(LLM)」に関連するAIニュースと解説、183本。新しい順に並べています。
大規模言語モデル(LLM) の記事:183件
Hugging Faceのtransformersがllama.cppのGGUF量子化を直接実行可能に ggmlカーネルを流用し対応は当面Apple Silicon・Qwen3.5系のみ
Hugging Faceのtransformersがllama.cppのGGUF量子化を直接実行可能にggmlカーネルを流用し対応は当面Apple Silicon・Qwen3.5系のみ
検証
Mistral(ミストラル)、1兆パラメータの Mistral Large 4 の重みを公開 コーディングで公開重み首位とうたい、API価格は入力$0.70・出力$2.10
Mistral(ミストラル)、1兆パラメータの Mistral Large 4 の重みを公開コーディングで公開重み首位とうたい、API価格は入力$0.70・出力$2.10
モデル
Sakana AI(サカナAI)、企業向け「Sakana API Platform」のアーリーアクセスを開始 組織・ワークスペース管理と監査ログ付き、OpenAI互換でFuguを先行提供
Sakana AI(サカナAI)、企業向け「Sakana API Platform」のアーリーアクセスを開始組織・ワークスペース管理と監査ログ付き、OpenAI互換でFuguを先行提供
プロダクト
Upstage、『Solar Pro 4』のtokenizerをHugging Faceで公開 重みは含まず、公式ガイドでは翌日リリースのSolar Mini 4と共用。Pro 2・Pro 3のtokenizerの後にも重みは出ていない
Upstage、『Solar Pro 4』のtokenizerをHugging Faceで公開重みは含まず、公式ガイドでは翌日リリースのSolar Mini 4と共用。Pro 2・Pro 3のtokenizerの後にも重みは出ていない
モデル
 動画
Gemini 4 Carbon(ジェミニ4 カーボン)発表 公式の表でOpus 5.5を16項目中14項目で上回る。ただし提供はサイバー防御者に限定
Gemini 4 Carbon(ジェミニ4 カーボン)発表公式の表でOpus 5.5を16項目中14項目で上回る。ただし提供はサイバー防御者に限定
モデル
Tencent(テンセント)、中国語の論理推論ベンチマークHyperLogic(ハイパーロジック)を一部公開 各階層の約30%と評価コード、Baseの正答率は7モデルで44.6〜77.6%
Tencent(テンセント)、中国語の論理推論ベンチマークHyperLogic(ハイパーロジック)を一部公開各階層の約30%と評価コード、Baseの正答率は7モデルで44.6〜77.6%
研究
xAI、Grok(グロック)のAPIにリクエスト単位の「Custom moderation controls」を追加 nsfw・violence・profanityの3カテゴリを個別に抑えられる
xAI、Grok(グロック)のAPIにリクエスト単位の「Custom moderation controls」を追加nsfw・violence・profanityの3カテゴリを個別に抑えられる
プロダクト
Ai2、LLMによる研究アイデアの新規性判定は不安定と報告 プロンプトの違いでGPT-5.4の正答率が93.5%から40.9%に
Ai2、LLMによる研究アイデアの新規性判定は不安定と報告プロンプトの違いでGPT-5.4の正答率が93.5%から40.9%に
研究
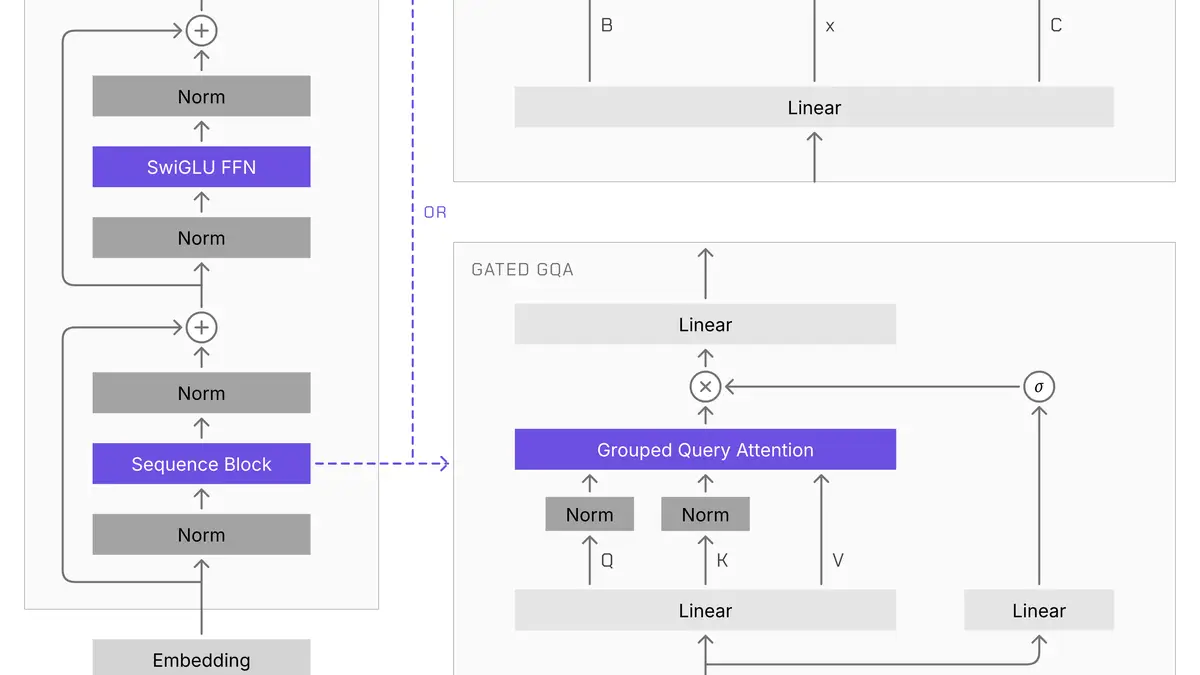
Liquid AI(リキッドAI)、2B級オープンウェイトのLFM3(エルエフエム・スリー)6モデルを公開 LFM3-1.7BはLFM2.5-2.6Bを35%少ないパラメータで上回ると同社
Liquid AI(リキッドAI)、2B級オープンウェイトのLFM3(エルエフエム・スリー)6モデルを公開LFM3-1.7BはLFM2.5-2.6Bを35%少ないパラメータで上回ると同社
モデル
Microsoft AI、セキュリティ特化モデル MAI Cyber 1.1 Flash を MDASH で公開 性能は前版並みで1スキャンのコストが18%減と発表
Microsoft AI、セキュリティ特化モデル MAI Cyber 1.1 Flash を MDASH で公開性能は前版並みで1スキャンのコストが18%減と発表
モデル
NVIDIA、DGX Spark(ディージーエックス スパーク)でLing-3.0-flashを速める3手法を公開 GSM8K全1,319問でデコード+42.5%、精度はほぼ同じと報告
NVIDIA、DGX Spark(ディージーエックス スパーク)でLing-3.0-flashを速める3手法を公開GSM8K全1,319問でデコード+42.5%、精度はほぼ同じと報告
検証
NVIDIA、ゲーム用の小型AIモデル Nemotron 3.5 Bolt E4B 4GB(ネモトロン ボルト)を公開 RTX Spark(スパーク)はDLSS 5に対応、新モデルは9月版の2倍速
NVIDIA、ゲーム用の小型AIモデル Nemotron 3.5 Bolt E4B 4GB(ネモトロン ボルト)を公開RTX Spark(スパーク)はDLSS 5に対応、新モデルは9月版の2倍速
プロダクト
 動画
GPT-6.1 Terra(テラ)登場 入力$1・出力$5でGPT-6 Astraと同点、OpenAI公式の表6枚を点ごとに読む
GPT-6.1 Terra(テラ)登場入力$1・出力$5でGPT-6 Astraと同点、OpenAI公式の表6枚を点ごとに読む
モデル
 動画
Kimi K3.1 Pro(キミ ケーサンテンイチ プロ)登場 公式ベンチ14種目中6種目で1位、Opus 5.5と競りながらAPIは半額。重みは11月4日までに公開
Kimi K3.1 Pro(キミ ケーサンテンイチ プロ)登場公式ベンチ14種目中6種目で1位、Opus 5.5と競りながらAPIは半額。重みは11月4日までに公開
モデル
AWS、SageMaker AIに学習ループを自分のPythonで書ける「training session APIs(トレーニングセッションAPI)」 GPUの運用はAWS任せ、課金はトークン単位
AWS、SageMaker AIに学習ループを自分のPythonで書ける「training session APIs(トレーニングセッションAPI)」GPUの運用はAWS任せ、課金はトークン単位
プロダクト
Google CloudのAPI Gateway(APIゲートウェイ)がストリーミングに対応 SSE・WebSocket・gRPCをパブリックプレビューで、gcloudの--enable-streamingで有効化
Google CloudのAPI Gateway(APIゲートウェイ)がストリーミングに対応SSE・WebSocket・gRPCをパブリックプレビューで、gcloudの--enable-streamingで有効化
プロダクト
NVIDIA、DGX Spark(ディージーエックス スパーク)の8台クラスターを公式サポート 統合メモリ1TBでGLM 5.3(753B)を動かし、デコードは1台比で最大4.43倍と発表
NVIDIA、DGX Spark(ディージーエックス スパーク)の8台クラスターを公式サポート統合メモリ1TBでGLM 5.3(753B)を動かし、デコードは1台比で最大4.43倍と発表
プロダクト
 動画
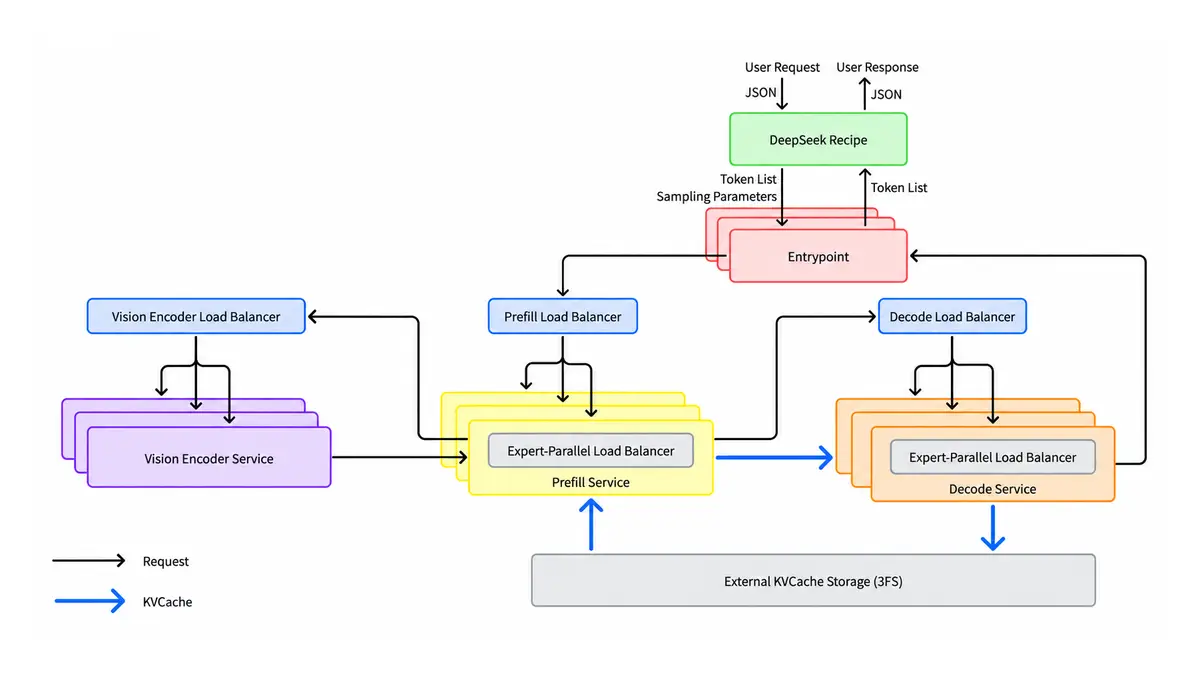
DeepSeekが推論フレームワーク「DeepInfer」を公開 本番で使っている仕組みの中身と、安さの理由
DeepSeekが推論フレームワーク「DeepInfer」を公開本番で使っている仕組みの中身と、安さの理由
検証
OpenAI、ChatGPTの広告配信の仕組みを公開 専用に追加学習したLLMが候補の取得・ランキング・オークションを呼び出し、回答とは別サービスで動く
OpenAI、ChatGPTの広告配信の仕組みを公開専用に追加学習したLLMが候補の取得・ランキング・オークションを呼び出し、回答とは別サービスで動く
プロダクト
Ai2、LLMの公平性を「説得されたときの変わりやすさ」で測るFairStress(フェアストレス)を公開 300場面・1,300万件超、データとコードも配布
Ai2、LLMの公平性を「説得されたときの変わりやすさ」で測るFairStress(フェアストレス)を公開300場面・1,300万件超、データとコードも配布
研究
Google、MetaのTorchTitan(トーチタイタン)をCloud TPU向けに公開 Llama 3 405Bは1,024チップまで約57% MFU、Qwen3 235Bは32.42%と発表
Google、MetaのTorchTitan(トーチタイタン)をCloud TPU向けに公開Llama 3 405Bは1,024チップまで約57% MFU、Qwen3 235Bは32.42%と発表
検証
Google、TPUでPyTorchが直接動くTorchTPU上に「vLLM-TorchTPU」と「SGLang-TorchTPU」を公開 Ironwoodで100万トークン2.01セント、SGLang版はMetaで本番稼働と発表
Google、TPUでPyTorchが直接動くTorchTPU上に「vLLM-TorchTPU」と「SGLang-TorchTPU」を公開Ironwoodで100万トークン2.01セント、SGLang版はMetaで本番稼働と発表
検証
Hugging Face、Swift向けAnyLanguageModel(エニーランゲージモデル)1.0を公開 importを差し替えるだけで端末内モデルとOpenAI・Anthropic・Geminiを切り替え、swift-huggingface・swift-xetも1.0に
Hugging Face、Swift向けAnyLanguageModel(エニーランゲージモデル)1.0を公開importを差し替えるだけで端末内モデルとOpenAI・Anthropic・Geminiを切り替え、swift-huggingface・swift-xetも1.0に
検証
Hugging Face、PyTorch 2.15(パイトーチ)のMac向けGPU「MPS」の改善を公開 MoEモデルの生成が2.14比5〜6.5倍、動画デコードのメモリは270GiBから8GiBに
Hugging Face、PyTorch 2.15(パイトーチ)のMac向けGPU「MPS」の改善を公開MoEモデルの生成が2.14比5〜6.5倍、動画デコードのメモリは270GiBから8GiBに
検証