
ローカルAIの記事
「ローカルAI」に関連するAIニュースと解説、55本。新しい順に並べています。
ローカルAI の記事:55件
Hugging Faceのtransformersがllama.cppのGGUF量子化を直接実行可能に ggmlカーネルを流用し対応は当面Apple Silicon・Qwen3.5系のみ
Hugging Faceのtransformersがllama.cppのGGUF量子化を直接実行可能にggmlカーネルを流用し対応は当面Apple Silicon・Qwen3.5系のみ
検証
Hugging Face、Apple端末向けSwiftパッケージ AnySpeechRecognizer(エニー・スピーチ・レコグナイザー)とAnyDecisionModelを公開 Parakeet・Qwen3-ASRを端末内で動かし、確率つきの判断も
Hugging Face、Apple端末向けSwiftパッケージ AnySpeechRecognizer(エニー・スピーチ・レコグナイザー)とAnyDecisionModelを公開Parakeet・Qwen3-ASRを端末内で動かし、確率つきの判断も
検証
Apple、MacBook Pro(マックブック プロ)にMac初のタッチ操作とPROLED XDRディスプレイ M5 Pro/M5 Max搭載、米国2,899ドルから11月6日発売
Apple、MacBook Pro(マックブック プロ)にMac初のタッチ操作とPROLED XDRディスプレイM5 Pro/M5 Max搭載、米国2,899ドルから11月6日発売
プロダクト
GitHub Copilot Fusion(フュージョン)、端末内のローカルモデルとクラウドを自動で使い分ける実験的プレビュー CLI・Copilotアプリ・VS Codeで、WindowsはMAI Code 1.1 Flashを管理付きでダウンロード
GitHub Copilot Fusion(フュージョン)、端末内のローカルモデルとクラウドを自動で使い分ける実験的プレビューCLI・Copilotアプリ・VS Codeで、WindowsはMAI Code 1.1 Flashを管理付きでダウンロード
検証
Google、Android向けLiteRT(ライトアールティー)のPlay services版でGPU推論が約1.4倍に アプリは約8MB小さく、旧GPUデリゲートは非推奨
Google、Android向けLiteRT(ライトアールティー)のPlay services版でGPU推論が約1.4倍にアプリは約8MB小さく、旧GPUデリゲートは非推奨
検証
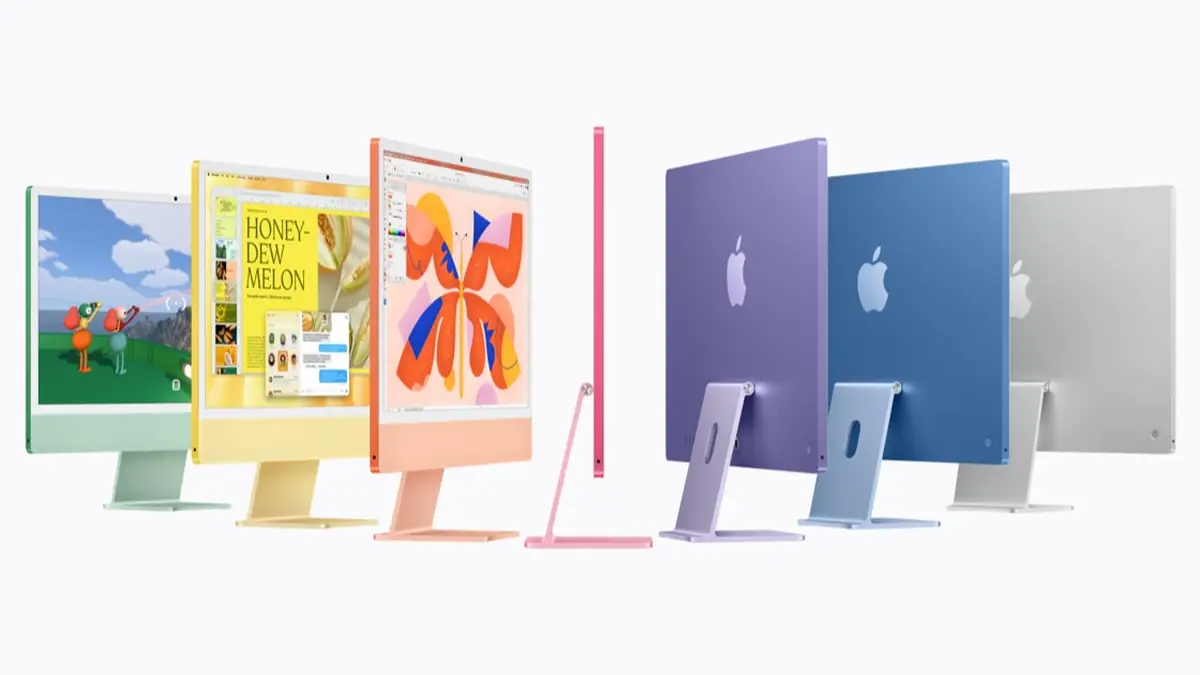
Apple、M6搭載の新型iMac(アイマック)を発表 1,499ドルから、予約は10月28日・発売は11月6日、端末内AIはM4比で最大5倍と同社
Apple、M6搭載の新型iMac(アイマック)を発表1,499ドルから、予約は10月28日・発売は11月6日、端末内AIはM4比で最大5倍と同社
プロダクト
Apple、M6搭載の14インチMacBook Pro(マックブック プロ)を発表 米国1,999ドルから、予約10月28日・発売11月6日、端末内AIはM5比で最大25%と同社
Apple、M6搭載の14インチMacBook Pro(マックブック プロ)を発表米国1,999ドルから、予約10月28日・発売11月6日、端末内AIはM5比で最大25%と同社
プロダクト
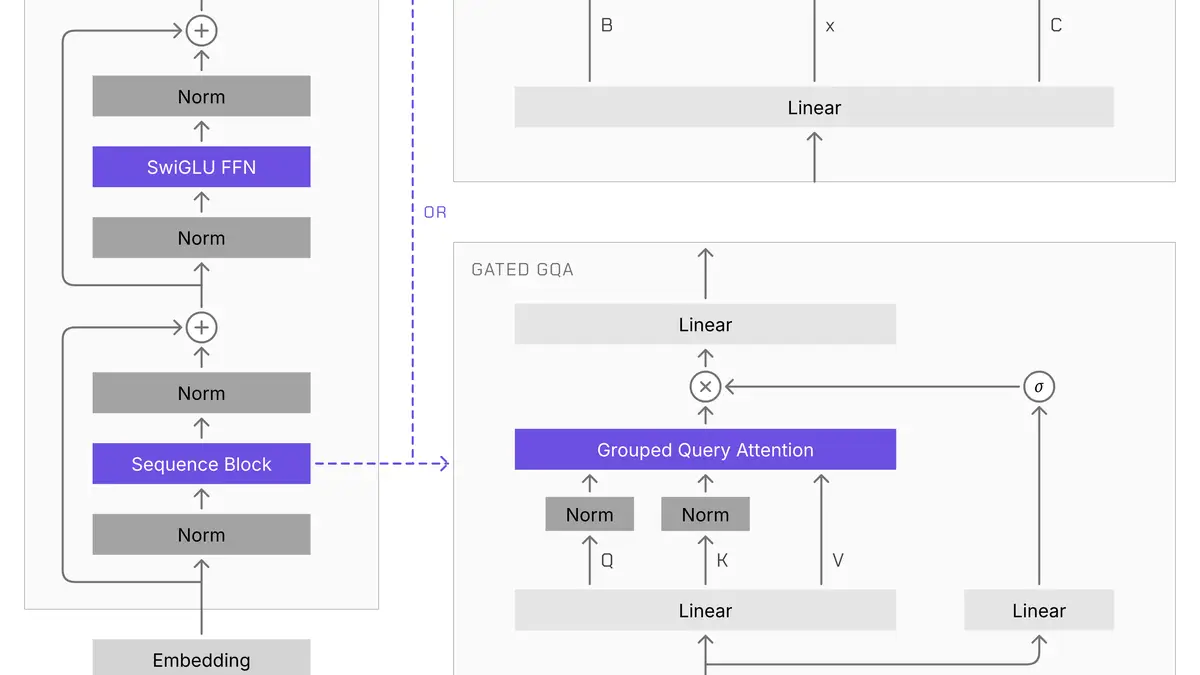
Liquid AI(リキッドAI)、2B級オープンウェイトのLFM3(エルエフエム・スリー)6モデルを公開 LFM3-1.7BはLFM2.5-2.6Bを35%少ないパラメータで上回ると同社
Liquid AI(リキッドAI)、2B級オープンウェイトのLFM3(エルエフエム・スリー)6モデルを公開LFM3-1.7BはLFM2.5-2.6Bを35%少ないパラメータで上回ると同社
モデル
NVIDIA、DGX Spark(ディージーエックス スパーク)でLing-3.0-flashを速める3手法を公開 GSM8K全1,319問でデコード+42.5%、精度はほぼ同じと報告
NVIDIA、DGX Spark(ディージーエックス スパーク)でLing-3.0-flashを速める3手法を公開GSM8K全1,319問でデコード+42.5%、精度はほぼ同じと報告
検証
NVIDIA、ゲーム用の小型AIモデル Nemotron 3.5 Bolt E4B 4GB(ネモトロン ボルト)を公開 RTX Spark(スパーク)はDLSS 5に対応、新モデルは9月版の2倍速
NVIDIA、ゲーム用の小型AIモデル Nemotron 3.5 Bolt E4B 4GB(ネモトロン ボルト)を公開RTX Spark(スパーク)はDLSS 5に対応、新モデルは9月版の2倍速
プロダクト
Tencent(テンセント)、文章とカメラ操作で世界の動画を作り続けるHy-NomasをApache 2.0で公開 RTX 4090 1枚の構成も用意
Tencent(テンセント)、文章とカメラ操作で世界の動画を作り続けるHy-NomasをApache 2.0で公開RTX 4090 1枚の構成も用意
モデル
IBM Research、Granite(グラナイト)時系列モデル4種を再学習なしで束ねる「Granite Timeseries Ensemble r1」を公開 GIFT-Evalの97構成でMASE 0.683、単体最良の0.685をわずかに上回る
IBM Research、Granite(グラナイト)時系列モデル4種を再学習なしで束ねる「Granite Timeseries Ensemble r1」を公開GIFT-Evalの97構成でMASE 0.683、単体最良の0.685をわずかに上回る
モデル
NVIDIA、DGX Spark(ディージーエックス スパーク)の8台クラスターを公式サポート 統合メモリ1TBでGLM 5.3(753B)を動かし、デコードは1台比で最大4.43倍と発表
NVIDIA、DGX Spark(ディージーエックス スパーク)の8台クラスターを公式サポート統合メモリ1TBでGLM 5.3(753B)を動かし、デコードは1台比で最大4.43倍と発表
プロダクト
NVIDIA、GTC BerlinでDGX Spark 64GBを10月23日に提供開始 DGX Station for Windowsは12月、コーディングモデル Recursive Flint(リカーシブ・フリント)も公開と発表
NVIDIA、GTC BerlinでDGX Spark 64GBを10月23日に提供開始DGX Station for Windowsは12月、コーディングモデル Recursive Flint(リカーシブ・フリント)も公開と発表
プロダクト
Hugging Face、Swift向けAnyLanguageModel(エニーランゲージモデル)1.0を公開 importを差し替えるだけで端末内モデルとOpenAI・Anthropic・Geminiを切り替え、swift-huggingface・swift-xetも1.0に
Hugging Face、Swift向けAnyLanguageModel(エニーランゲージモデル)1.0を公開importを差し替えるだけで端末内モデルとOpenAI・Anthropic・Geminiを切り替え、swift-huggingface・swift-xetも1.0に
検証
Hugging Face、PyTorch 2.15(パイトーチ)のMac向けGPU「MPS」の改善を公開 MoEモデルの生成が2.14比5〜6.5倍、動画デコードのメモリは270GiBから8GiBに
Hugging Face、PyTorch 2.15(パイトーチ)のMac向けGPU「MPS」の改善を公開MoEモデルの生成が2.14比5〜6.5倍、動画デコードのメモリは270GiBから8GiBに
検証
Google、オンデバイスAI用LiteRT(ライトアールティー)にC++でモデルを組み立てる「Tensor API(テンソルAPI)」 SAM 2はMacBook ProでApple MLX比約1.5倍と同社
Google、オンデバイスAI用LiteRT(ライトアールティー)にC++でモデルを組み立てる「Tensor API(テンソルAPI)」SAM 2はMacBook ProでApple MLX比約1.5倍と同社
検証
NVIDIA、RTX Spark(スパーク)搭載PCで「コード・テスト・デプロイを1台で」 Intel Panther Lake比でコーディングエージェント4.6倍と主張、Windows on ArmにPyTorch-CUDA
NVIDIA、RTX Spark(スパーク)搭載PCで「コード・テスト・デプロイを1台で」Intel Panther Lake比でコーディングエージェント4.6倍と主張、Windows on ArmにPyTorch-CUDA
プロダクト
NVIDIA、RTX Spark(スパーク)搭載Windowsノートの世界発売を発表 ASUS・Dell・HP・Lenovo・Microsoft・MSIの9機種、2,599ドルから
NVIDIA、RTX Spark(スパーク)搭載Windowsノートの世界発売を発表ASUS・Dell・HP・Lenovo・Microsoft・MSIの9機種、2,599ドルから
プロダクト
Apple、MLX(エムエルエックス)とThunderbolt 5のRDMAでMac Studio 4台をつなぎ、816B(8,160億)パラメータのMuse Spark Openを毎秒36トークン超で動かす手順と実測を公開 M5 UltraのTTFTはM3 Ultra比で最大4.6倍
Apple、MLX(エムエルエックス)とThunderbolt 5のRDMAでMac Studio 4台をつなぎ、816B(8,160億)パラメータのMuse Spark Openを毎秒36トークン超で動かす手順と実測を公開M5 UltraのTTFTはM3 Ultra比で最大4.6倍
研究
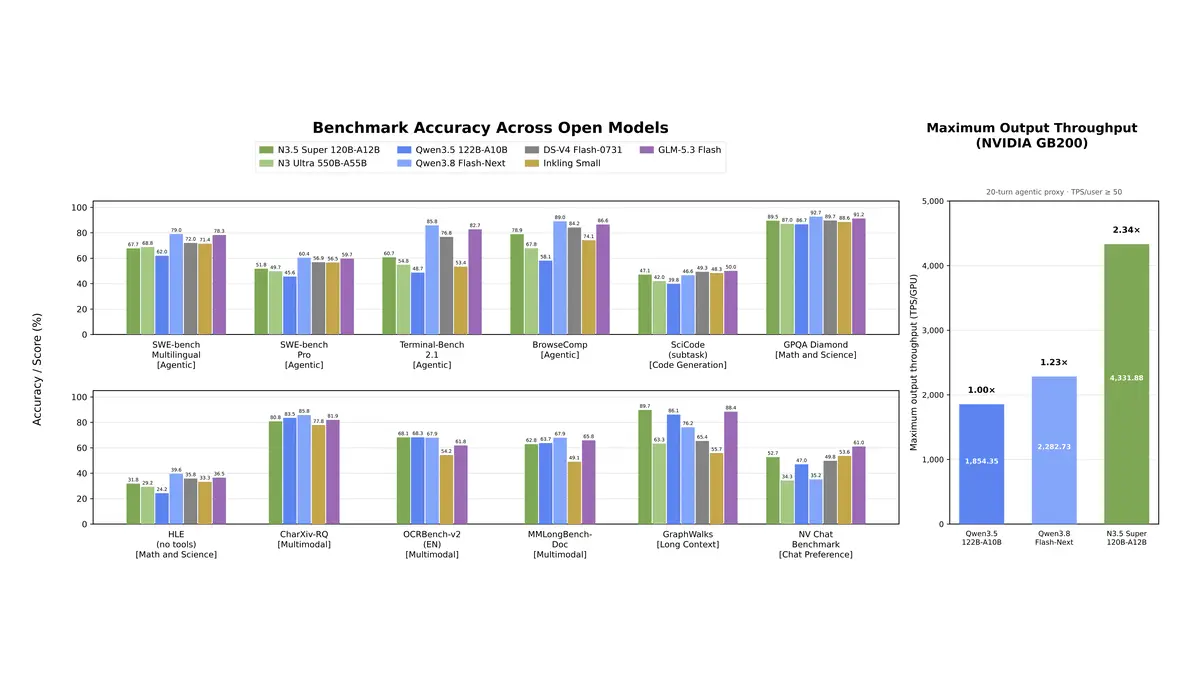
NVIDIA、画像と動画も読む「Nemotron(ネモトロン)3.5 Super VL」を公開 120B・有効12B、公式グラフの首位は12項目中1つで速さはQwen3.5の2.34倍
NVIDIA、画像と動画も読む「Nemotron(ネモトロン)3.5 Super VL」を公開120B・有効12B、公式グラフの首位は12項目中1つで速さはQwen3.5の2.34倍
モデル
Liquid AI(リキッドAI)、アクティブ2Bの推論モデル「LFM2.5-24B-A2B」をオープンウェイトで公開 LiveClawは48.09でQwen3.6-35B-A3Bの38.19を上回る(同社測定)
Liquid AI(リキッドAI)、アクティブ2Bの推論モデル「LFM2.5-24B-A2B」をオープンウェイトで公開LiveClawは48.09でQwen3.6-35B-A3Bの38.19を上回る(同社測定)
モデル
NVIDIA、RTX Spark(スパーク)搭載PCの10月16日発売を前に「Nemotron 3.5 Bolt 74B」を15日公開へ PAIR(ペア)は正式版、Broadcast 2.3は配布中
NVIDIA、RTX Spark(スパーク)搭載PCの10月16日発売を前に「Nemotron 3.5 Bolt 74B」を15日公開へPAIR(ペア)は正式版、Broadcast 2.3は配布中
プロダクト
Google「EmbeddingGemma 2」公開 文字・画像・動画・音声を1つのベクトルにする7.4億パラメータのオープンモデル、手元のMacで日本語の検索を試した
Google「EmbeddingGemma 2」公開文字・画像・動画・音声を1つのベクトルにする7.4億パラメータのオープンモデル、手元のMacで日本語の検索を試した
モデル