GPT-6のプロンプトキャッシュ改善を読む──割引90%・書き込み1.25倍・TTL30分はGPT-5.6と同じ、ダッシュボードと診断ツールは8〜9月に公開済み、発表前日のガイドに無かったのはプリウォーム
OpenAIは2026年9月22日付の発表で、GPT-6ファミリーのプロンプトキャッシュを改良し既定のヒット率を高めたと説明したが、発表には改善幅を示すOpenAI自身の数字は無く、GitHub・Strawberry Browser・Manus・Wordsmithの4社の自己申告(新規処理が要るトークンの割合50%超減、コスト20%減、ヒット率約85%→90%超、評価時83%→91%)が載っている。キャッシュ読み出し0.1倍・書き込み1.25倍・TTL30分は公式ガイドがGPT-5.6以降に共通として示す値のままで、発表が紹介したダッシュボードと診断ツールはOpenAIの変更履歴では8月20日と9月8日に公開済み。当サイトがWayback Machineに残る9月21日時点のガイドと現在のガイドを突き合わせた範囲では、9月21日の記録に無く現在はある節が事前ウォームアップ(prewarm)だった。
目次
OpenAIは2026年9月22日付(公式サイトの表記)で、「Better prompt caching for GPT‑6」(日本語版の題は「GPT‑6 のプロンプトキャッシュを強化」)を公開した。発表によると、GPT‑6ファミリーでは既定でキャッシュヒット率が高くなる改良版のプロンプトキャッシュを導入し、あわせてキャッシュ性能の監視、キャッシュミスの診断、プロンプトのどこまでをキャッシュするかの選択を助ける道具を紹介している。OpenAIは同じ日にGPT‑6 SolとGPT‑6 Lunaを公開しており、その発表にもキャッシュ改善の節がある。
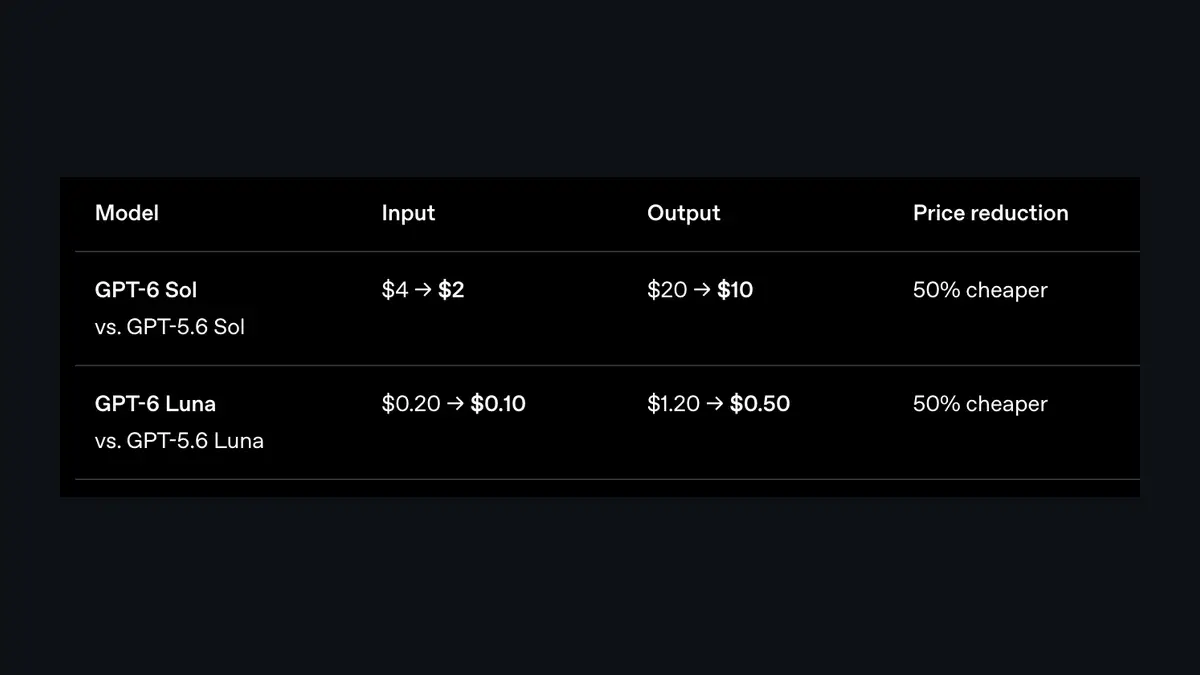
本稿は日本時間2026年9月25日0時台に、発表ページ(英語版・日本語版)、公式ドキュメントの「Prompt caching」ガイドと診断ツールのガイド、料金表、API変更履歴を直接開いて書いている。API利用者の支払いに関わる点を先に書くと、キャッシュの倍率(読み出しは通常入力の0.1倍、書き込みは1.25倍)とTTL(30分)は、公式ガイドが「GPT-5.6 and later」としてまとめている値のままで、GPT‑6向けに変わった数字は無い。単価のほうは、同日のSol・Luna発表でOpenAIが、キャッシュと推論の改善を理由にSolとLunaのAPI価格をGPT‑5.6のプロモーション価格から50%下げた、と書いている。
3行まとめ
- OpenAIは2026年9月22日付で、GPT‑6ファミリーのプロンプトキャッシュを改良し既定のヒット率を高めたと発表した。キャッシュ読み出し0.1倍(最大90%引き)・書き込み1.25倍・TTL30分は、公式ガイドがGPT‑5.6以降に共通として示す値で、今回変わっていない(日本時間9月25日に公式ガイドと料金表で確認)
- 発表が紹介したPrompt Caching Dashboardは8月20日、Prompt Cache Diagnosticsは9月8日に、OpenAIのAPI変更履歴で公開済み。当サイトがWayback Machineに残る9月21日時点のガイドと現在のガイドを突き合わせた範囲では、9月21日の記録に無く現在はある節が事前ウォームアップ(prewarm)で、推論量の途中変更の対象は「GPT-6 Astra」から「GPT-6 models」に書き換わっていた
- ヒット率の改善幅についてOpenAI自身の数字は発表に無い。載っているのはGitHub(新規処理が要るトークンの割合を50%超削減)、Strawberry Browser(コスト20%削減)、Manus(ヒット率約85%→90%超)、Wordsmith(評価時のヒット率83%→91%、推論コスト36%減)の4社の自己申告
GPT-6ファミリーのキャッシュ料金とTTL(Standard・Short context、100万トークンあたり)
| モデル | 通常入力 | キャッシュ読み出し(0.1倍) | キャッシュ書き込み(1.25倍) | 出力 | TTL |
|---|---|---|---|---|---|
| gpt-6-astra | $10.00 | $1.00 | $12.50 | $50.00 | 30分 |
| gpt-6-sol | $2.00 | $0.20 | $2.50 | $10.00 | 30分 |
| gpt-6-luna | $0.10 | $0.01 | $0.125 | $0.50 | 30分 |
単価は日本時間2026年9月25日にOpenAI公式の料金ページ(developers.openai.com/api/docs/pricing)の「Standard pricing data」で確認したもの。キャッシュ読み出しは通常入力の0.1倍(=90%引き)、書き込みは1.25倍で、同じ表のgpt-5.6-sol(通常入力$4.00・読み出し$0.40・書き込み$5.00)と同じ倍率になっている。
書き込みの1.25倍は、通常の入力料金に上乗せされる手数料ではない。公式ガイドは次のように断っている。
"Cache-write pricing is not an additive fee: input tokens use the uncached-input, cached-input, or cache-write rate."
(キャッシュ書き込みの料金は加算される手数料ではない。入力トークンには、キャッシュなしの入力・キャッシュ済みの入力・キャッシュ書き込みのいずれか1つの単価が適用される)
同じガイドの試算では、あるプレフィックスを1回書き込んで1回まるごと再利用すると通常入力の1.35倍、キャッシュせずに2回処理すると2倍。10リクエストなら書き込み1回と読み出し9回で2.15倍、キャッシュなしでは10倍になる。TTLはprompt_cache_options.ttlで指定し、サポートされる値は既定値でもある30mだけ。キャッシュされたプレフィックスは直近の書き込みか再利用から30分間は再利用の対象として残り、OpenAIがそれより長く保持することもある、とガイドは書いている。
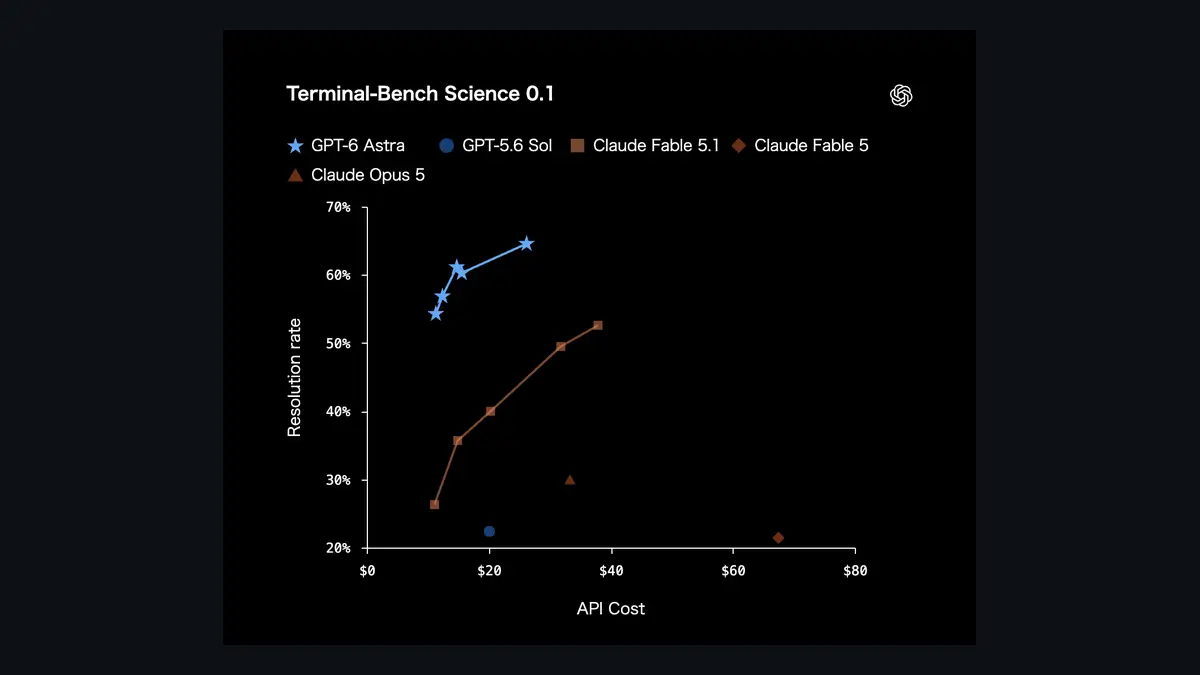
モデルごとの単価について。Astraの入力$10・出力$50は、9月3日の公開時に報じた価格から変わっていない。SolとLunaは9月22日付で公開されたモデルで(GPT-6 SolとLunaの公開記事)、OpenAIのSol・Luna発表は値下げの理由を次のように書いている。
"Improvements in caching and inference let us serve these models at lower cost, and we’re passing those savings directly on to users and customers by reducing API prices for Sol and Luna by 50% compared with their GPT‑5.6 promotional pricing."
(キャッシュと推論の改善でこれらのモデルを低いコストで提供できるようになったため、その分を利用者と顧客に直接還元し、SolとLunaのAPI価格をGPT‑5.6のプロモーション価格から50%引き下げる)
本稿の整理では、キャッシュ改善が利用者の支払いに届く経路は、倍率やTTLの変更ではなく、ヒット率そのものの改善と、OpenAIがキャッシュを理由の一つに挙げた基本単価の引き下げの2つになる。他社(Claude・Gemini)を含めた単価比較はClaude・GPT・Gemini API料金の読み方にまとめている。
「30分以内の再利用に割引」はGPT-6で新しく決まった値ではない
発表本文は、GPT‑6が支える永続的なエージェントがコードベースのリファクタリングから調査に基づく文書やプレゼンテーションの作成まで数時間かけて取り組み、その裏のアプリケーションは以前のターンと同じ指示・ツール定義・コンテキストを引き継ぐ一連のAPIリクエストを送る、という前提を置いている。そのうえで次のように書く。
"With the GPT‑6 family, we launched an improved prompt caching system that delivers higher cache hit rates by default. We now give cache discounts for eligible shared prefixes reused within a 30-minute window."
(日本語版の訳文:GPT‑6 ファミリーでは、デフォルトでより高いキャッシュヒット率を実現する、改良版のプロンプトキャッシュシステムを導入しました。現在は、30 分以内に再利用された対象の共有プレフィックスにキャッシュ割引を適用しています。)
この30分は、GPT‑6で新しく決まった値ではない。当サイトが2026年9月1日に公開したプロンプトキャッシュが効いていない時のサインは、GPT‑5.6以降の保持期間の設定値が"30m"だけであることを当時の公式ドキュメントで確認している。現在のガイドでも同じ記述が「GPT-5.6 and later」の区分に載っている。発表の中でGPT‑6固有と読めるのは「既定でヒット率が高くなる」という仕組み側の改良で、その改善幅を示すOpenAI自身の数字は、発表ページにも同日のSol・Luna発表にも無かった(本稿が確認した範囲)。
ダッシュボードと診断ツールは、変更履歴では8月と9月に公開済み
発表は「新しいPrompt Caching Dashboard」と「プロンプトキャッシュ診断ツール」を紹介している。ダッシュボードは、アプリケーションへの入力のうちキャッシュから提供された割合を示し、ヒット率の推移と、キャッシュ済み・未キャッシュのトークンを比べる入力構成グラフを見られる、と発表は説明する。
ただしOpenAIのAPI変更履歴(Changelog)では、ダッシュボードは2026年8月20日の項で「Released the Prompt Caching dashboard」として、ヒット率の推移や、キャッシュ読み出し・書き込み・未キャッシュのトークンの内訳を見られるものとして公開されている(当サイトも8月のAPI変更5件の記事で扱った)。診断ツールも、9月8日の項で「Prompt Cache Diagnostics is now generally available in the Responses API for GPT-5.6 and later supported models.」と一般提供が告知されている。どちらもGPT‑6ファミリー専用ではなく、診断ツールの対象はGPT‑5.6以降だ。発表が「new」と呼ぶ道具は、変更履歴の上では発表より前に出ていたことになる。
診断ツールの使い方は専用ガイドにある。比較の基準にしたい直近のレスポンスのidを、次のリクエストのprompt_cache_options.comparison_response_idに入れると、そのレスポンスにprompt_cache_diagnosticsが付く。発表ページと診断ツールのガイドに載っている出力例は次のとおり。
{
  "prompt_cache_diagnostics": {
    "type": "cache_miss",
    "reason": "tools_changed",
    "comparison_reusable_tokens": 5629,
    "cache_missed_tokens": 5629
  }
}
ガイドの定義では、comparison_reusable_tokensは比較対象のレスポンスが持っていた再利用可能なプレフィックスのトークン数、cache_missed_tokensはそのうち再利用されなかったと推定されるトークン数。この例では、ツール定義の変更(tools_changed)で5,629トークンがすべて再利用されなかった、という読みになる。原因の分類はmodel_changed・prompt_cache_key_changed・tools_changed・reasoning_effort_changed・context_compacted・input_changedなど9種類がガイドの表に並ぶ。報告されるのは最初に分類された1つの原因だけなので、直したら比較をやり直すようガイドは勧めている。診断そのものに追加料金はかからず、レート制限にも別に数えられない。
発表前日の記録と9月25日のガイドを比べて変わっていた2か所
発表は「改訂されたプロンプトキャッシュガイド」を案内している。当サイトは、Wayback Machineに残る2026年9月21日4時31分(UTC、発表の前日)の同ガイドの記録と、日本時間9月25日に取得した現在のガイドを突き合わせた。はっきり違っていたのは次の2か所だった。
- 事前ウォームアップ(Prewarm the cache)の節が加わった。 9月21日の記録には無い。現在のガイドによると、Responses APIのリクエストで
prompt_cache_options.prewarmをtrueにすると、出力を生成せずにプロンプトキャッシュを準備できる。準備が終わったら、同じプレフィックスでprewarmを省くかfalseにした本番のリクエストを送る。用途の例として、アプリの起動時、ユーザーが最初の質問をする前に共有の指示・ツール定義・参考資料を準備しておく使い方が挙がっている。対象は「GPT-5.6 and later」で、GPT‑6専用ではない。prewarmで書き込まれたトークンは通常のキャッシュ書き込み単価(GPT‑5.6以降は1.25倍)で課金される。 - 推論量の途中変更(
configuration_update)の対象の書き方が変わった。 9月21日の記録では「On GPT-6 Astra」、現在は「On GPT-6 models」。リクエスト単位のreasoning.effortは変えずにconfiguration_updateという入力項目を足すと、キャッシュ済みのプレフィックスを保ったまま次の返答からの推論量を上げ下げできる。この機能自体は9月3日の変更履歴でGPT‑6 Astra向けに出ていて、当サイトも9月6日のGPT-6 Astra公式ガイド解説で扱っている。現在の推論ガイドは対応範囲を「GPT-6 model family in standard, single-agent mode」と書いていて、9月22日付で公開されたSolとLunaにも広がった形になる。
prewarmの課金規定から計算すると、prewarmで書き込んだプレフィックスが一度も読まれないまま終われば、通常入力の1.25倍を払っただけになる。ガイドが再利用の対象として示す期間は書き込みから最低30分(それより長く残ることもある)なので、起動してからユーザーが最初の質問をするまで30分を超えがちなアプリでは、起動時に一律でprewarmする設計は割高になりうる(本稿の計算で、公式の記述ではない)。
ツールの出し入れについては、発表とリンク先のガイドで挙げている項目が少し違う。発表は、ツール定義・スキーマ・順序を固定したまま、allowed_toolsで呼び出せるツールを絞る、ツールが不要ならtool_choiceをnoneにする(定義は消さない)、新しい指示は新しいdeveloperメッセージとしてコンテキストの末尾近くに足して古い指示を上書きする、を挙げている。リンク先のガイドの節(Manage tools with append-only updates)に並ぶのは、定義を固定する、tool_choiceを"none"にする、allowed_toolsで絞る、ツール検索とdefer_loading: trueで必要になるまで定義を読み込まない、additional_tools入力項目でスレッドの途中にツールを足す、の5項目で、developerメッセージで指示を上書きする話はこの節には無い。
4社の数字は、それぞれ何を測ったものか
発表ページの証言は、冒頭にGitHubのロゴとともに載った1件と、Strawberry Browser・Manus・Wordsmithの3社をタブで切り替える欄に分かれている。切り替え欄はページを開いた時点では1社目しか見えないが、ページのHTMLには3社分の本文がすべて入っていた。数字を含む文を、英語版の原文とOpenAI日本語版ページの訳文で並べる。
GitHub(Mario Rodriguez氏、Chief Product Officer。GitHub Copilotについての証言)
"Over the past several months, we’ve reduced by more than 50% the share of prompt tokens requiring fresh processing across billions of requests to OpenAI models, relative to our previous baseline."
(日本語版の訳文:過去数か月で、OpenAI モデルへの数十億件のリクエストを通じ、新たな処理が必要なプロンプトトークンの割合を、従来の基準から 50% 以上削減しました。)
Strawberry Browser(Arian Hanifi氏、Chief Technology Officer)
"OpenAI’s prompt caching diagnostics and dashboard helped us improve cache hit rates by a few percentage points, reducing costs by 20%."
(日本語版の訳文:OpenAI のプロンプトキャッシュ診断とダッシュボードにより、キャッシュヒット率を数ポイント改善し、コストを 20% 削減できました。)
Manus(Bin Fan氏、Agent Team Lead)
"In less than a week, our OpenAI model cache hit rate went from roughly 85% to consistently above 90%, further lowering inference costs in production."
(日本語版の訳文:1 週間足らずで、OpenAI モデルのキャッシュヒット率は約 85% から安定して 90% 超へと上昇し、本番環境の推論コストもさらに低下しました。)
Wordsmith(Eugene Mikhantyev氏、AI Engineer)
"In under a week, cache hit rates on our evaluations rose from 83% to 91%. This meant fewer cache writes and lower inference costs with the same workload; the cache writes fell by roughly two-thirds, and inference costs by 36%."
(日本語版の訳文:1 週間足らずで、評価時のキャッシュヒット率は 83% から 91% に上昇しました。同じワークロードのまま、キャッシュ書き込み回数と推論コストを削減できました。キャッシュ書き込みは約 3 分の 2、推論コストは 36% 減少しました。)
いずれもOpenAIの発表ページに載った各社の自己申告で、第三者の検証は付いていない。読むときに分けておきたいのは、何が効いたと各社が書いているかだ。Manusは同じ証言の中で、OpenAIのエンジニアリングチームと組んでキャッシュブレークポイントの配置を調整し、明示的キャッシュと自動キャッシュを組み合わせたと書いている。Wordsmithはセッションエージェントを明示的キャッシュブレークポイントに移したと書いている。どちらもOpenAIと連携して自社の設定を変えた結果で、GPT‑6の既定の改良だけで出た数字としては書かれていない。Wordsmithの83%→91%は「評価時(on our evaluations)」の値で、本番の値とは書かれていない。Strawberry Browserは、ヒット率の改善は「数ポイント」でコストは20%減、という組み合わせで書いている。GitHubの証言は「過去数か月」がいつからいつまでか、「従来の基準」がどの時点かを書いておらず、数か月という期間は9月3日のGPT‑6 Astra公開より前にさかのぼる。この50%をGPT‑6の既定の改良だけの効果として読むことはできない、というのが本稿の読みである。
本稿が依拠した一次情報と取得方法
- OpenAI「Better prompt caching for GPT‑6」(2026年9月22日付。英語版・日本語版とも日本時間9月25日0時台に取得。
openai.comはcurlに403を返すため、ヘッドレスブラウザで開き、証言の切り替え欄はページのHTMLから読んだ): https://openai.com/index/better-prompt-caching-for-gpt-6/ (日本語版 https://openai.com/ja-JP/index/better-prompt-caching-for-gpt-6/ ) - OpenAI「Introducing GPT‑6 Sol and Luna」(2026年9月22日付。キャッシュ改善の節と値下げの理由): https://openai.com/index/introducing-gpt-6-sol-and-luna/
- OpenAI API Docs「Prompt caching」: https://developers.openai.com/api/docs/guides/prompt-caching
- OpenAI API Docs「Prompt cache diagnostics」: https://developers.openai.com/api/docs/guides/prompt-caching/diagnostics
- OpenAI API Docs「Pricing」(gpt-6-astra/sol/lunaとgpt-5.6-solの行): https://developers.openai.com/api/docs/pricing
- OpenAI API Docs「Changelog」(8月20日・9月3日・9月8日の項): https://developers.openai.com/api/docs/changelog
- Wayback Machineに残る「Prompt caching」の2026年9月21日04:31(UTC)の記録: https://web.archive.org/web/20260921043111/https://developers.openai.com/api/docs/guides/prompt-caching
9月21日の記録と9月25日のガイドの比較は、Wayback Machineが記録した時点と当サイトが取得した時点の2点どうしの比較である。9月21日の記録から発表までの間にガイドが何度書き換えられたかは分からない。
出典・参照資料
- 一次資料Better prompt caching for GPT‑6 | OpenAI(英語版・日本語版) ↗
- 一次資料Introducing GPT‑6 Sol and Luna | OpenAI(キャッシュ改善の節と値下げの理由) ↗
- 一次資料Prompt caching — OpenAI API Docs ↗
- 一次資料Prompt cache diagnostics — OpenAI API Docs ↗
- 一次資料Pricing — OpenAI API Docs ↗
- 一次資料Changelog — OpenAI API Docs(8月20日・9月3日・9月8日の項) ↗
- 二次資料Prompt caching(Wayback Machine、2026年9月21日04:31 UTCの記録) ↗
AIニュースの解説を動画でも
YouTubeでは注目ニュースの背景を解説し、Xでは新着記事をお知らせしています。
コメント
まだコメントはありません。最初のコメントを書いてみませんか?
AIについて聞きたいことはありますか?
質問箱で無料で受け付けています。回答は公開され、他の方の参考にもなります。
質問箱を見る →新しい記事をメールで受け取る
AIの新しい発表を、出典付きで整理して届けます。
関連記事
GPT-6 SolとLunaが公開──API価格は5.6世代から半額の入力2ドル/出力10ドル、公式表ではOpus 5のmaxを上回る
プロンプトキャッシュが効いていない時のサイン──OpenAI公式ドキュメントが認める「キャッシュが逆に高くつく」5パターン
OpenAI API、8月の実務変更5件──プロンプトキャッシュ可視化から透過背景画像まで
GPT-6 Astra公式ガイド「Using GPT-6 Astra」全体解説──癖5つと対処法11本、公式が「強く推奨」したのはプロンプトを足すことではない
GPT-6 Astra公開──自社比較表では首位、独立指標では5位、価格はFable 5.1と同額の$10/$50
Claude・GPT・Gemini API料金の読み方──2026年8月27日に公式ページで確認した単価早見表
GPT-6 Astra vs Claude Fable 5.1 比較──同じ$10/$50で何が違うか。公式ベンチの突合・独立指標・プラン別に使える条件・キャッシュ単価の4倍差を1枚に