NVIDIA「メガワットからトークンへ」同じ電力予算で19ノードを85%出力で回すと、16ノード全開よりトークン処理量24%増(Lambdaの実測、HGX B200)。電力会社の信号でAI工場の消費を4MWから3MWへ1分未満で自動調整(Emerald AI・Silicon Valley Power、200回超すべて成功)。DSX Flex初の商用配備は96MWのVera Rubin工場
日刊AIニュース10月17日(土)号:前日のAIのニュース17本を短くまとめました(約8分)›
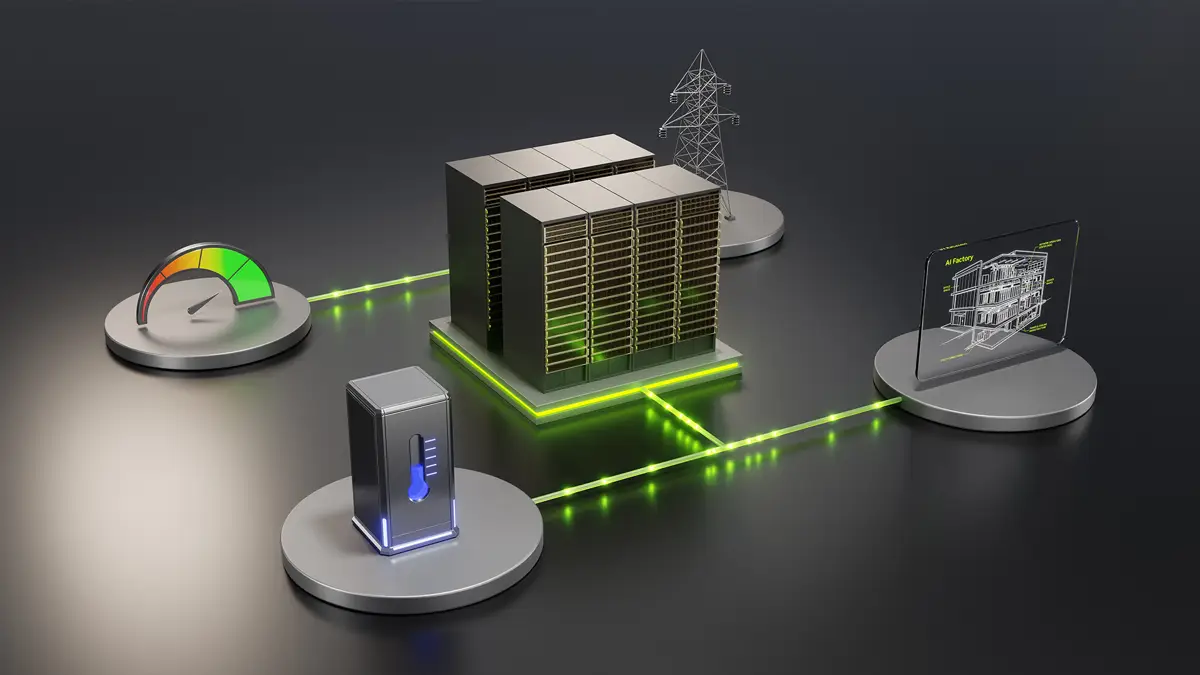
NVIDIAは2026年9月15日、AI Infra Summitに合わせて「From Megawatts to Tokens」を公開した。AI工場の制約は電力で、指標は「ギガワットあたりの仕事量」だとして、DSXの電力管理の実績を並べる。クラウド事業者Lambdaは5ラック19ノードのHGX B200でDSX MaxLPSを検証し、16ノードを全開で回すのと同じ電力予算で19ノードを85%出力で回すと、クラスタ全体のトークン処理量が毎秒約400万から約500万へ24%増、ワットあたり性能は23%改善した。Vera Rubin NVL72では同じ電力予算で最大40%多いGPU容量を見込む。系統側では、NVIDIAのEos工場がEmerald AIのConductorでSilicon Valley Powerの需要信号に応じ、4MWから3MWへ優先度の低いジョブを遅らせて自動で下げた。同社は200回超の信号を送り、毎回成功したという。DSX Flex初の商用配備はバージニア州マナサスの96MW Vera Rubin工場。
2026年9月18日・日本時間時点の情報です。 NVIDIAのブログ(9月15日)を読んだ。翌16日のEmerald AI・Google・NVIDIAの柔軟なデータセンター連合の前日に出た「実績編」で、数字が具体的なので単独で残す。データセンターの電力問題の全体像はAIの電力消費とデータセンターに。
3行まとめ
- 同じ電力で多く回す(DSX MaxLPS)。 GPUとラック単位の消費電力を常時監視し、静的な割り当てでは死んでいた余力をワークロードの種類に応じて配り直す。クラウド事業者Lambdaが5ラック19ノードのHGX B200で検証し、16ノードを全開で回すのと同じ電力予算で19ノードを85%出力で回すと、クラスタ全体のトークン処理量が毎秒約400万→約500万で24%増、ワットあたり性能は23%改善。NVIDIAの見込みでは、次世代のVera Rubin NVL72では同じ電力予算で最大40%多いGPU容量。
- 電力会社の信号で自動で下げる(DSX Flexの原型)。 8月のある夕方、電力会社Silicon Valley PowerがAI工場に需要調整の信号を送った。NVIDIAのEos工場で動くEmerald AIのConductorが、あらかじめ決めた優先順位に沿って低優先度のジョブを遅らせ、高優先度の推論は止めずに4MWから3MWへ自動で下げた。操作員は触っていない。同社はその後200回超の信号を送り、毎回成功したという(表では「1分未満で40%削減」)。Silicon Valley Powerの「Flexible Load Interconnect Program」は、AI工場を系統側から指令できる資源として扱う初の商用プログラムとされる。
- これから。 DSX Flex初の商用配備はバージニア州マナサスの96MW Vera Rubin工場(NVIDIAのAI Factory Research Center)。次の層は800V直流の給電で、54V配電に対して端から端まで3〜5%の効率改善を見込み、Vera Rubin NVL72では2027年に使えるとする。DSX全体はMaxLPS・Flex・OS(オープンソース)・Sim・Reference Designsの5本。
「24%増」はLambda自身が測った数字
- 「1ギガワットの工場は2ギガワットの工場にはならない」(Jensen Huang氏の言として引用)が全体の前提で、電力を増やせないなら電力あたりのトークンで競う、という話だ
- Lambdaの数字はNVIDIAのソフトをNVIDIAのGPUで、Lambdaが自社環境で測ったもの。第三者の測定ではない
- 系統側の話は、当サイトが16日に書いたAEMA連合の「柔軟なデータセンター」を、実際に信号を受けて下げた例として補う
- 同じ週にVera Rubin NVL72のMLPerf Inference v6.1デビューも出ており、性能と電力の両面を同時に売り込んでいる
本文と数字表で確かめた実測値
この記事の下調べで、筆者は9月18日にNVIDIAのブログを取得し、Lambdaの数字(19対16ノード・85%・24%・23%・400万→500万)、Eos工場の4MW→3MW・200回超、マナサス96MW、800V DCの3〜5%がその原文(本文と末尾の「Numbers at a glance」表)にあることを確認した。筆者はAI Infra Summitの講演を視聴していない。
学習比率や価格など、本文にない情報
- Lambdaの検証で回したワークロードの内訳(学習と推論の比率)
- Eos工場の「40%削減」が4MW→3MW(25%)とどう対応するのか(表と本文で数字の切り方が違う)
- DSX MaxLPSの提供形態と価格
原題「Megawatts to Tokens」
- From Megawatts to Tokens: How NVIDIA Maximizes AI Factory Production(NVIDIA・2026年9月15日)
関連記事
出典・参照資料
大きいニュースはYouTubeでも解説しています。Xでは新着記事をお知らせしています。
コメント
まだコメントはありません。最初のコメントを書いてみませんか?
AIについて聞きたいことはありますか?
質問箱で無料で受け付けています。回答は公開され、他の方の参考にもなります。
質問箱を見る →関連記事
Emerald AI・Google・NVIDIAが「AI Energy Management Alliance(AEMA)」を設立 AIデータセンターを「電力を柔軟に減らせる資源」として電力網につなぐ。負荷の移動・蓄電・併設発電で系統の逼迫に応じ、接続前にライドスルー・抑制・緊急応答の義務を定め、検証可能な柔軟性を約束した事業者には速い接続経路を
Emerald AI・Google・NVIDIAが「AI Energy Management Alliance(AEMA)」を設立AIデータセンターを「電力を柔軟に減らせる資源」として電力網につなぐ。負荷の移動・蓄電・併設発電で系統の逼迫に応じ、接続前にライドスルー・抑制・緊急応答の義務を定め、検証可能な柔軟性を約束した事業者には速い接続経路を
NVIDIAの次世代ラック「Vera Rubin NVL72」がMLPerf Inference v6.1に初登場 Qwen3-VLでGB300 NVL72の最大3.7倍、DeepSeek-R1で最大2.5倍(プレビュー提出)。GB300は4ラック288GPUで99%のスケーリング効率、ソフトウェア改善だけでv6.0比最大1.6倍。エージェント向け指標では30倍という自社測定も
NVIDIAの次世代ラック「Vera Rubin NVL72」がMLPerf Inference v6.1に初登場Qwen3-VLでGB300 NVL72の最大3.7倍、DeepSeek-R1で最大2.5倍(プレビュー提出)。GB300は4ラック288GPUで99%のスケーリング効率、ソフトウェア改善だけでv6.0比最大1.6倍。エージェント向け指標では30倍という自社測定も
生成AIのエネルギー消費と環境負荷 データセンター電力問題【2026年】
生成AIのエネルギー消費と環境負荷データセンター電力問題【2026年】
Google、データセンターの水使用量を上回る「水の補充」計画を発表 2030年までに年間190億ガロン超
Google、データセンターの水使用量を上回る「水の補充」計画を発表2030年までに年間190億ガロン超
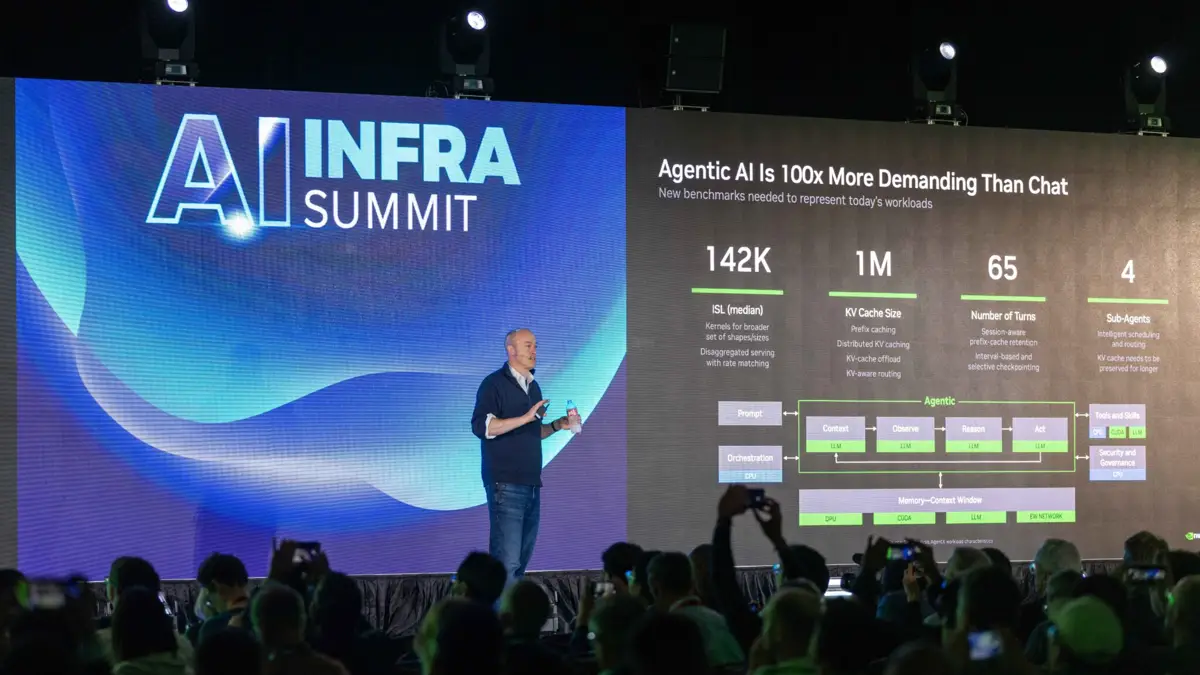
NVIDIA、AI Infra Summit 2026(来場8,000人超) 推論チップのd-MatrixがNVLink FusionでRaptor XPUをVera CPU・MGXラックに接続、AmazonのAnnapurna LabsがカスタムHBM「NVHBM」で協業、PinterestがBlackwellとDynamoで視覚検索。指標は「メガワット当たりのトークン」へ
NVIDIA、AI Infra Summit 2026(来場8,000人超)推論チップのd-MatrixがNVLink FusionでRaptor XPUをVera CPU・MGXラックに接続、AmazonのAnnapurna LabsがカスタムHBM「NVHBM」で協業、PinterestがBlackwellとDynamoで視覚検索。指標は「メガワット当たりのトークン」へ
NVIDIA GTC Washington, D.C. 2026は11月30日開幕 基調講演は12月1日Jensen Huang氏、AWS re:Inventと4日間重複しAWS自身がダイヤモンドスポンサーに
NVIDIA GTC Washington, D.C. 2026は11月30日開幕基調講演は12月1日Jensen Huang氏、AWS re:Inventと4日間重複しAWS自身がダイヤモンドスポンサーに
NVIDIAがオハイオ州の巨大データセンターを「自社AI計算資源の独占ホスト」に組み替え OpenAIは8IT-GWの「顧客」という立場に
NVIDIAがオハイオ州の巨大データセンターを「自社AI計算資源の独占ホスト」に組み替えOpenAIは8IT-GWの「顧客」という立場に