NVIDIA、IBC 2026で「AI for Media」を拡張AI生成動画の判定「Synthetic Video Detector」はテキスト→動画で99.3%・画像→動画で97.7%の精度になり、Dalet・TwelveLabs・Wowzaが組み込み。フレーム生成(リプレイで6倍スロー)、超解像の10ビット対応、SDR→HDR変換、LipSync、Studio Voice
日刊AIニュース11月7日(土)号:前日のAIのニュース3本を短くまとめました(約5分)›
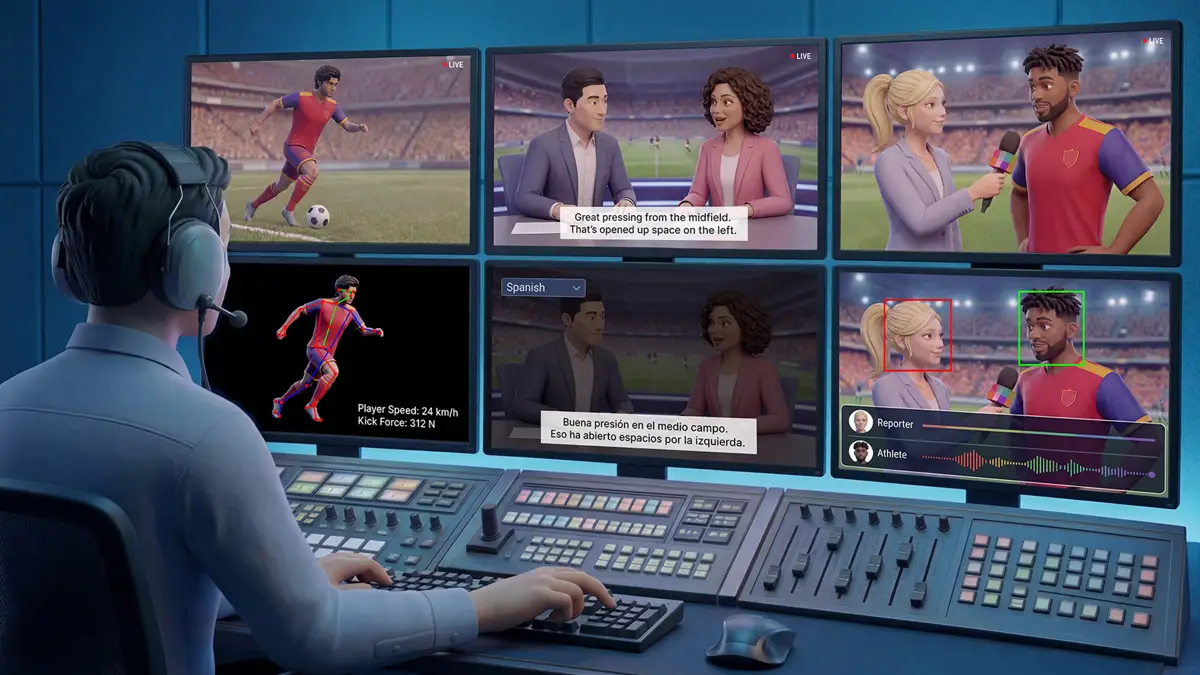
NVIDIAは2026年9月9日、アムステルダムのIBC 2026(9月11〜14日)に向けて、放送・スポーツ・制作向けのSDK・NIM群「AI for Media」の拡張を発表した。①Synthetic Video Detector(SVD):映像が本物かAI生成かの確率を評価し、精度はテキスト→動画で99.3%、画像→動画で97.7%に到達。Daletが報道機関向けの検証ワークフローに、TwelveLabsが「Compliance by TwelveLabs」に、Wowza(3万5,000超の配信)がライブ映像の解析に組み込む。②3D Body Pose:単一カメラの映像から関節位置を推定。③Video Frame Generation:中間フレームを生成して2倍・4倍、Ross Videoのリプレイで6倍スロー。④Video Super Resolution:10ビット対応。⑤TrueHDR:SDRをリアルタイムでHDR(約2,000ニト)に。⑥LipSyncと話者検出でNDIが翻訳・吹替を放送に。⑦Studio Voiceにマイクプロファイル。
2026年9月19日・日本時間時点の情報です。 NVIDIAのブログ(9月9日)を読んだ。動画を作る側として気になるのは、AI生成動画の判定器の精度と、リプレイや超解像のような制作の裏方の部品。当サイトの透かしと来歴(SynthID・C2PA)が「作る側の印」なら、こちらは「見る側の判定」。
3行まとめ
- AI生成動画の判定。 IBC 2026(アムステルダム、9月11〜14日、170超の国から4万4,000人超、1,300超の出展)でNVIDIAはAI for Media(放送・スポーツ・制作向けのSDK・NIMマイクロサービス・手引き・設計図)を拡張した。Synthetic Video Detector(SVD)は、映像が本物かAI生成かの確率を評価するNIMで、SIGGRAPHでの初公開以降、精度はテキスト→動画で99.3%、画像→動画で97.7%に到達(難しい画像→動画で大きく改善)。Daletが報道機関向けのクラウド検証ワークフローに組み込み(編集者が映像を投げてスコアとメタデータを見る)、TwelveLabsが一般提供したCompliance by TwelveLabs(地域・独自基準への適合を審査)にフレーム単位の真正性信号として統合、Wowza(170超の国で3万5,000超の配信を支える)がライブ映像の解析枠組みで配布し、オンプレ・エッジ・クラウド・完全隔離でも動く。
- 制作の部品。 3D Body Pose:単一カメラの映像から2D/3Dの関節位置と角度を推定し、マーカーなしで動作を構造化。スポーツの追跡・生体力学・判定・選手の安全に加え、キャラクターリグに写せばアニメのブロッキングやデジタルダブルに。Vizrtは仮想スタジオで追跡した体の動きで照明・影を駆動。Video Frame Generation(VFG):生成AIで中間フレームを作り2倍・4倍にし、Ross VideoのRio Replayで6倍スローモーション(8倍を開発中)。Video Super Resolution(VSR):ノイズ・ぼけ・圧縮ノイズを減らして拡大、リアルタイムと高品質のモード、10ビット対応。TrueHDR:SDRをリアルタイムでHDR(約2,000ニト)に。3つは1つの映像効果パイプラインで組み合わせられる。
- 音声と多言語。 LipSync(口の動きを目標音声に合わせ、頭の動き・まばたきは保つ。遮蔽の処理と歯・唇・肌の質感を改善)とActive Speaker Detection(複数音声トラックでの話者分離が不要に、音声区間検出を追加、gRPC対応)で、NDIが翻訳・口の動きを合わせた吹替・地域言語化を既存の放送ワークフローに載せる。Studio Voiceはノイズ抑制・残響低減・明瞭化の後にマイクプロファイルで音の性格を選べる。基盤側はHoloscan for Mediaに**Media Exchange Layer(MXL)**を統合し、ソフトウェア化した制作機能が映像・音声・データをやり取りする共通層に。スポーツ向けの「Sports Intelligence Playbooks」も。
精度はNVIDIA申告、判定ではなく確率
- SVDの99.3%/97.7%はNVIDIAの申告で、テスト集合や偽陽性率は書かれていない。「確率を出す」道具であって「判定を下す」道具ではない、と本文も「レビューのもう1つの分析点」と位置づける
- 判定器(SVD)と来歴の印(C2PA、Credentio)は補完関係で、印がない映像には判定器しか使えない
- VFGの「6倍スロー」は、TwelveLabsのRodeoのような編集AIと違い、放送のリプレイ装置に組み込む部品。個人の編集ソフトで使えるかは別
- LipSyncによる吹替はElevenLabsのDubbing v2と競合する領域で、NVIDIAは放送局のオンプレ向け
原文で確認した精度や倍率の数字
この記事の下調べで、筆者は9月19日にNVIDIAのブログを取得し、来場者数・99.3%/97.7%・Dalet/TwelveLabs/Wowzaの組み込み・3万5,000・2倍/4倍/6倍/8倍・10ビット・約2,000ニト・LipSyncと話者検出の改善点・NDI・MXLがその原文にあることを確認した。各パートナーの発表は開いていない。筆者はSVDを試していない。
評価データセットや価格は不明
- SVDの評価データセットと偽陽性率
- 各NIMの価格と提供形態(クラウド/オンプレ)
- 日本の放送局の採用
原題は「Real-Time AI at IBC」
関連記事
出典・参照資料
大きいニュースはYouTubeでも解説しています。Xでは新着記事をお知らせしています。
コメント
まだコメントはありません。最初のコメントを書いてみませんか?
AIについて聞きたいことはありますか?
質問箱で無料で受け付けています。回答は公開され、他の方の参考にもなります。
質問箱を見る →関連記事
AI動画に見えない透かしは入っているのか SynthIDとC2PAを公式資料で確認した
AI動画に見えない透かしは入っているのかSynthIDとC2PAを公式資料で確認した
Google「Credentio」 C2PAコンテンツ認証情報を検証するC++ライブラリをオープンソース化。約40のGoogle製品で数百億件の生成物を扱ってきたのと同じコードで、仕様2.2と2.4に対応。完全にローカルで検証(送信なし・即時判定)、数GBの動画でもメモリ消費は小さく、公式のC2PA Trust Listを渡せる。生成・埋め込みは今後
Google「Credentio」C2PAコンテンツ認証情報を検証するC++ライブラリをオープンソース化。約40のGoogle製品で数百億件の生成物を扱ってきたのと同じコードで、仕様2.2と2.4に対応。完全にローカルで検証(送信なし・即時判定)、数GBの動画でもメモリ消費は小さく、公式のC2PA Trust Listを渡せる。生成・埋め込みは今後
TwelveLabs、動画編集AIコパイロット「Rodeo」を発表、自然言語で素材を検索・編集
TwelveLabs、動画編集AIコパイロット「Rodeo」を発表、自然言語で素材を検索・編集
ElevenLabsが画像・動画生成APIに進出、ローカルMCPは廃止 changelogで確認する8月の3つの変更
ElevenLabsが画像・動画生成APIに進出、ローカルMCPは廃止changelogで確認する8月の3つの変更
NVIDIA「Magpie TTS Multilingual」 3億6,400万パラメータのオープンウェイト音声合成が日本語を含む12言語(新たにアラビア語・韓国語・ブラジルポルトガル語)、各言語に男女の話者、日本語の混在発音と発音辞書に対応。自社基盤で動かし、最初の音声までB200で32ms・H100で47ms・DGX Sparkで53ms、64並列でも実時間の320倍
NVIDIA「Magpie TTS Multilingual」3億6,400万パラメータのオープンウェイト音声合成が日本語を含む12言語(新たにアラビア語・韓国語・ブラジルポルトガル語)、各言語に男女の話者、日本語の混在発音と発音辞書に対応。自社基盤で動かし、最初の音声までB200で32ms・H100で47ms・DGX Sparkで53ms、64並列でも実時間の320倍
 動画
Tavus「Griffin」 ビデオ通話で54人中26人が「人間だった」と答えたAI、48%の測り方とNVIDIAの採点表を確かめる
Tavus「Griffin」ビデオ通話で54人中26人が「人間だった」と答えたAI、48%の測り方とNVIDIAの採点表を確かめる
YouTube「Made On YouTube 2026」発表 Shorts会話型AI編集・Live自動吹き替え・肖像検出の拡大、使える時期はバラバラ
YouTube「Made On YouTube 2026」発表Shorts会話型AI編集・Live自動吹き替え・肖像検出の拡大、使える時期はバラバラ