NVIDIA「Magpie TTS Multilingual」3億6,400万パラメータのオープンウェイト音声合成が日本語を含む12言語(新たにアラビア語・韓国語・ブラジルポルトガル語)、各言語に男女の話者、日本語の混在発音と発音辞書に対応。自社基盤で動かし、最初の音声までB200で32ms・H100で47ms・DGX Sparkで53ms、64並列でも実時間の320倍
日刊AIニュース11月7日(土)号:前日のAIのニュース3本を短くまとめました(約5分)›
NVIDIAは2026年8月10日、オープンウェイトの音声合成モデル「Magpie TTS Multilingual」の最新版を解説した。音声対話では音声合成が利用者に最も気づかれる最終段になる。統合型の音声モデルは1回のAPIで済むが部品ごとの微調整・入れ替え・データ所在の制御ができないため、ASR・TTS・LLMを分けた縦続構成を自社基盤で動かす部品としてMagpieを位置づける。364Mパラメータで、英・西・仏・独・伊・ベトナム・中国・ヒンディー・日本語に、新たにアラビア語・韓国語・ブラジルポルトガル語を加えた12言語。各言語に男女の声があり、IPAの書記素→音素処理と独自の発音辞書で、日本語の混在(名前・専門用語)の発音精度を上げた。NIMとして自社GPUで測った最初の音声までの遅延は、1ストリームでB200 32ms・H100 47ms・DGX Spark 53ms・A100 79ms、64並列でB200 239ms・実時間の約320倍。復号器が1段で2フレームを予測する「フレーム積み重ね」と品質を補う「局所Transformer」による(ICASSP 2026)。
2026年9月18日・日本時間時点の情報です。 Hugging FaceのNVIDIAのブログ(8月10日)を読んだ。当サイトの音声合成の比較(VOICEVOX・ElevenLabs)はクラウドと日本語特化の道具が中心で、「自社のGPUで動くオープンウェイトの多言語TTS」で日本語が入っているものは扱っていなかった。1か月前の記事だが、数字は具体的。
3行まとめ
- 位置づけ。 音声対話では、音声の取り込み→文字起こし→LLM→文脈検索→応答生成に時間を使った後、音声合成が利用者に最も気づかれる最終段になる。統合型の音声モデル(1回のAPIで音声入力→音声出力)は簡単だが、部品ごとの微調整・より良いモデルへの入れ替え・データ所在の要件・遅延の内訳の把握ができない。ASR・TTS・LLMを分けた縦続構成を自社基盤で動かすための部品として、Magpieはオープンウェイト+本番向けのNVIDIA NIMで提供される。
- 言語と日本語。 364Mパラメータで、英・西・仏・独・伊・ベトナム・中国(普通話)・ヒンディー・日本語に、今回アラビア語(現代標準)・韓国語・ブラジルポルトガル語を加えた12言語。各言語に共有の多言語話者表現による男女の声。IPAの書記素→音素処理と独自の発音辞書で、ヒンディー語と日本語のコードスイッチ(名前・専門用語・混合言語の文)の発音精度を上げた。地域ごとに別のTTSを保守しなくてよい、が売り。前版比で文字誤り率(CER)と話者類似度(SSIM)も改善し、はっきりした改善はフランス語(CER 2.70%→1.54%)とスペイン語。
- 遅延。 最初の音声までの遅延(TTFA)は、NIMとして自社GPUで測った値で、1ストリームでB200 32ms・H100 47ms・DGX Spark 53ms・A100 79ms、実時間比の処理量は9.8〜14.7倍。64並列ではB200 239ms・実時間の約320倍(H100 275ms・291倍、DGX Spark 962ms・76倍、A100 395ms・197倍。NIM性能文書v26.07、3回の平均、オンプレ)。「B200の32msなら、残りの遅延予算をASRとLLMに回し、自然な会話に要る200ms未満に収まる」。速さの仕組みは、復号器が1段で2フレームを予測して反復を半減する「フレーム積み重ね」と、同時生成するコードブック間の依存で落ちる品質を補う「局所Transformer」(ICASSP 2026の論文)。Hugging Faceの重みは研究・微調整用、NIMは本番向けの最適化コンテナで、どちらも自分の機器で動く。
「53ms」は机上のDGX Spark実測
- 日本語の音質の評価値は本文にない(CER/SSIMの表で明示されるのはフランス語・スペイン語)。日本語で使うなら自分で聞いて判断する対象で、筆者は未確認
- 「DGX Sparkで53ms」は、当サイトのNVIDIA IFA 2026で見た机上機で音声エージェントの合成段が回る、という意味。64並列では962msなので、多人数同時は大きいGPU向け
- 音声エージェントの評価はADKのライブ評価、読み間違いの検出はTTSの読み間違いに
- ElevenLabsのようなクラウドと違い、話者のクローンや感情制御の機能は本文で触れられていない
原文表で確かめた遅延と対応言語
この記事の下調べで、筆者は9月18日にHugging FaceのNVIDIAのブログを取得し、364M・12言語と新規3言語・日本語のコードスイッチ・TTFAとRTFXの表の数値・v26.07・フレーム積み重ねと局所Transformer・フランス語のCERがその原文にあることを確認した。NIMの性能文書とICASSPの論文は開いていない。筆者はMagpieで日本語を合成していない。
CER・ライセンス・音声クローンは未記載
- 日本語のCER・SSIM
- ライセンスの詳細(オープンウェイトの条件)
- 音声クローンや感情・話速の制御
出典はHugging FaceのNVIDIAのブログ
- Build Low-Latency Multilingual Voice Agents: Open Weights & Full Deployment Control with NVIDIA Magpie TTS(NVIDIA・2026年8月10日)
関連記事
出典・参照資料
大きいニュースはYouTubeでも解説しています。Xでは新着記事をお知らせしています。
コメント
まだコメントはありません。最初のコメントを書いてみませんか?
AIについて聞きたいことはありますか?
質問箱で無料で受け付けています。回答は公開され、他の方の参考にもなります。
質問箱を見る →関連記事
AI音声合成・読み上げツール比較 VOICEVOX/ElevenLabs/Azure【2026年】
AI音声合成・読み上げツール比較VOICEVOX/ElevenLabs/Azure【2026年】
ElevenLabsの料金と使い方【2026年9月版】 無料(月1万クレジット)から$6・$22・$99・$299・$990の6段階、クレジットの消費(文字1・文字起こし1分330・音楽1分900・吹き替え1分2,000)、商用利用と音声クローンの条件、年払い・繰り越しの仕組み
ElevenLabsの料金と使い方【2026年9月版】無料(月1万クレジット)から$6・$22・$99・$299・$990の6段階、クレジットの消費(文字1・文字起こし1分330・音楽1分900・吹き替え1分2,000)、商用利用と音声クローンの条件、年払い・繰り越しの仕組み
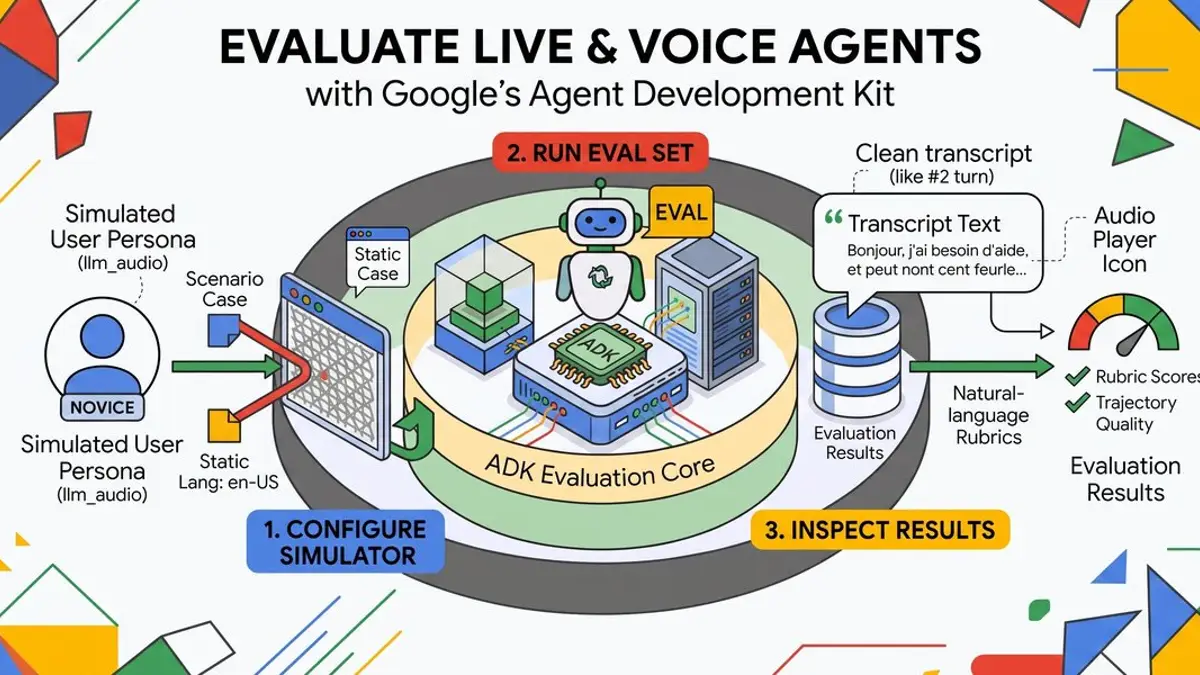
Google ADKに「ライブ・音声エージェントの評価」 模擬ユーザーがGemini TTSで話し、音声の返答をルーブリックで採点。名前確認→生年月日の検証(ツール呼び出し)→予約案内の3段ワークフローを、会話計画とペルソナ(NOVICE等)で即興させるか台本どおりに回す。test_config.jsonのlive_model_configを外せば同じケースをテキストで実行、CI/CDにも
Google ADKに「ライブ・音声エージェントの評価」模擬ユーザーがGemini TTSで話し、音声の返答をルーブリックで採点。名前確認→生年月日の検証(ツール呼び出し)→予約案内の3段ワークフローを、会話計画とペルソナ(NOVICE等)で即興させるか台本どおりに回す。test_config.jsonのlive_model_configを外せば同じケースをテキストで実行、CI/CDにも
TTSの読み間違いはASRで書き起こしても検出できない 「一行」を「いっこう」と読ませた音声が、元テキストと差分ゼロで戻ってきた実測
TTSの読み間違いはASRで書き起こしても検出できない「一行」を「いっこう」と読ませた音声が、元テキストと差分ゼロで戻ってきた実測
NVIDIA、IFA 2026でローカルAIの4本 Hermes Agent・OpenClaw・Perplexity Portable Computerがワンクリックでローカルモデル設定、llama.cppはRTX 5090で最大1.9倍、家庭内の遊休PCに推論を振り分ける無料OSS「PAIR」(Apple M4以降も)、10月にRTX Spark搭載Windows PC
NVIDIA、IFA 2026でローカルAIの4本Hermes Agent・OpenClaw・Perplexity Portable Computerがワンクリックでローカルモデル設定、llama.cppはRTX 5090で最大1.9倍、家庭内の遊休PCに推論を振り分ける無料OSS「PAIR」(Apple M4以降も)、10月にRTX Spark搭載Windows PC
Hugging Face、Apple端末向けSwiftパッケージ AnySpeechRecognizer(エニー・スピーチ・レコグナイザー)とAnyDecisionModelを公開 Parakeet・Qwen3-ASRを端末内で動かし、確率つきの判断も
Hugging Face、Apple端末向けSwiftパッケージ AnySpeechRecognizer(エニー・スピーチ・レコグナイザー)とAnyDecisionModelを公開Parakeet・Qwen3-ASRを端末内で動かし、確率つきの判断も
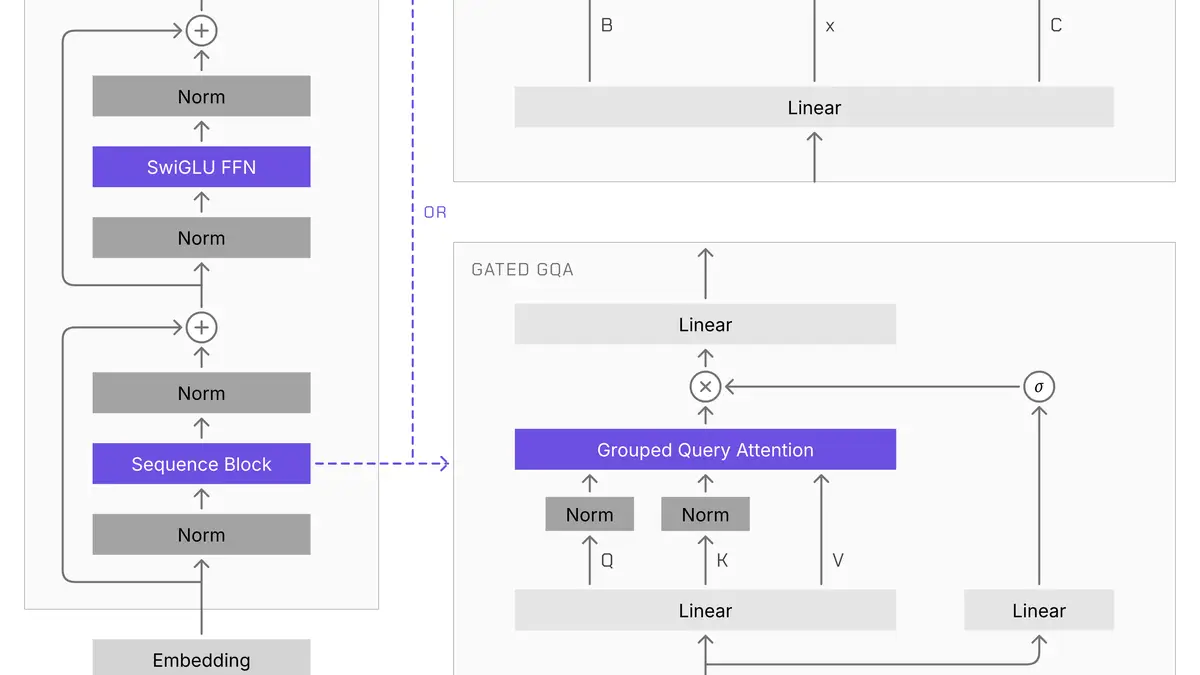
Liquid AI(リキッドAI)、2B級オープンウェイトのLFM3(エルエフエム・スリー)6モデルを公開 LFM3-1.7BはLFM2.5-2.6Bを35%少ないパラメータで上回ると同社
Liquid AI(リキッドAI)、2B級オープンウェイトのLFM3(エルエフエム・スリー)6モデルを公開LFM3-1.7BはLFM2.5-2.6Bを35%少ないパラメータで上回ると同社