
音声AI・文字起こしの記事
「音声AI・文字起こし」に関連するAIニュースと解説、41本。新しい順に並べています。
音声AI・文字起こし の記事:41件
Cursor(カーソル)、コーディングエージェントと声で通話できる「Voice Chat」を提供開始 デスクトップ・Web・iOSで、音声はGrok Voice
Cursor(カーソル)、コーディングエージェントと声で通話できる「Voice Chat」を提供開始デスクトップ・Web・iOSで、音声はGrok Voice
プロダクト
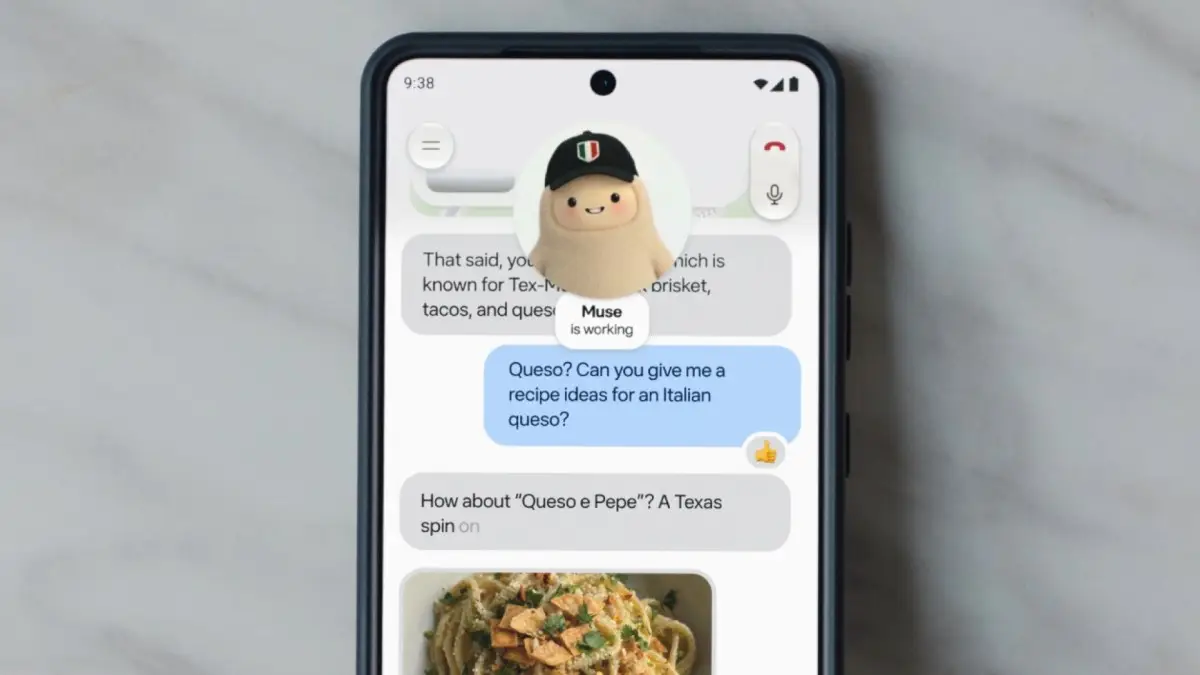
Meta、Museアプリに音声会話と表情で反応するアバターを追加 技術名はMuse Realtime Voice(ミューズ リアルタイム ボイス)、割り込み可能で米国から順次提供
Meta、Museアプリに音声会話と表情で反応するアバターを追加技術名はMuse Realtime Voice(ミューズ リアルタイム ボイス)、割り込み可能で米国から順次提供
プロダクト
 動画
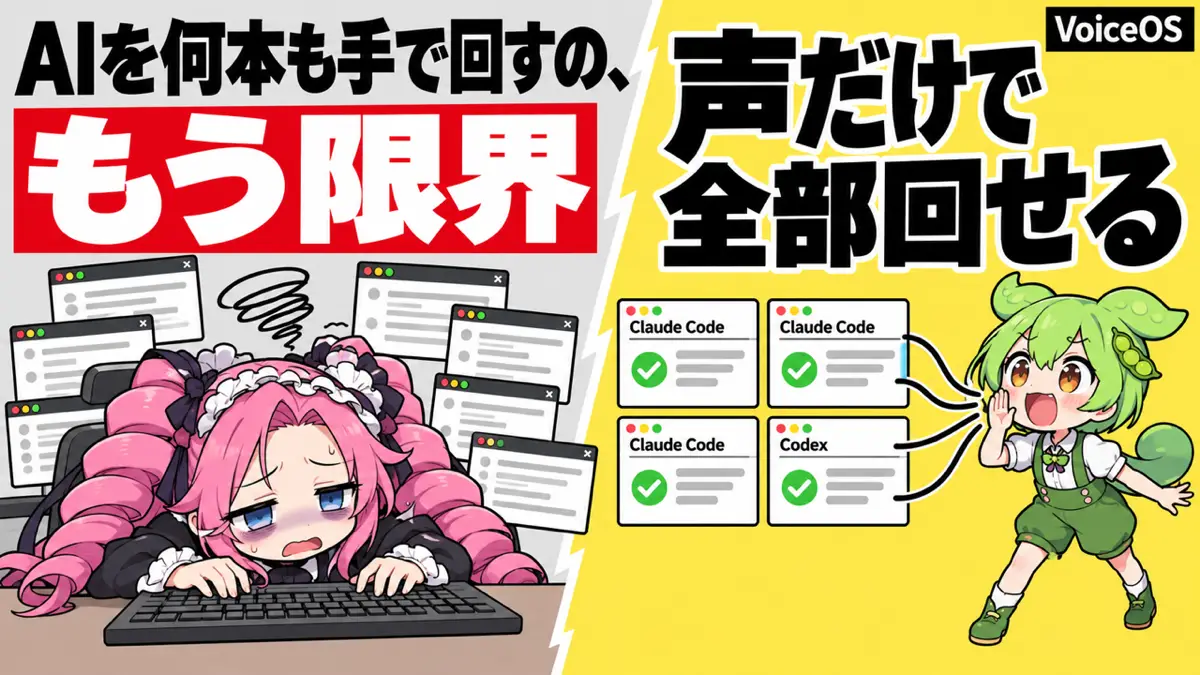
VoiceOSでClaude Code 3本とCodexを声だけで回した 複数セッションの管理も手打ちもいらなくなる
VoiceOSでClaude Code 3本とCodexを声だけで回した複数セッションの管理も手打ちもいらなくなる
プロダクト
SpaceXAI(旧xAI)、Grok Voice Transcribe 2.0を公開 同社発表は「1.0の2倍の精度」、価格は1.0と同額
SpaceXAI(旧xAI)、Grok Voice Transcribe 2.0を公開同社発表は「1.0の2倍の精度」、価格は1.0と同額
モデル
Hugging Face、Apple端末向けSwiftパッケージ AnySpeechRecognizer(エニー・スピーチ・レコグナイザー)とAnyDecisionModelを公開 Parakeet・Qwen3-ASRを端末内で動かし、確率つきの判断も
Hugging Face、Apple端末向けSwiftパッケージ AnySpeechRecognizer(エニー・スピーチ・レコグナイザー)とAnyDecisionModelを公開Parakeet・Qwen3-ASRを端末内で動かし、確率つきの判断も
検証
NVIDIA、40言語の文字起こし・話者識別・翻訳・音声Q&Aを1つでこなすオープンウェイトの音声モデル Nemotron 3.5 Transcribe(ネモトロン)を公開 学習データ Granary v2 も
NVIDIA、40言語の文字起こし・話者識別・翻訳・音声Q&Aを1つでこなすオープンウェイトの音声モデル Nemotron 3.5 Transcribe(ネモトロン)を公開学習データ Granary v2 も
モデル
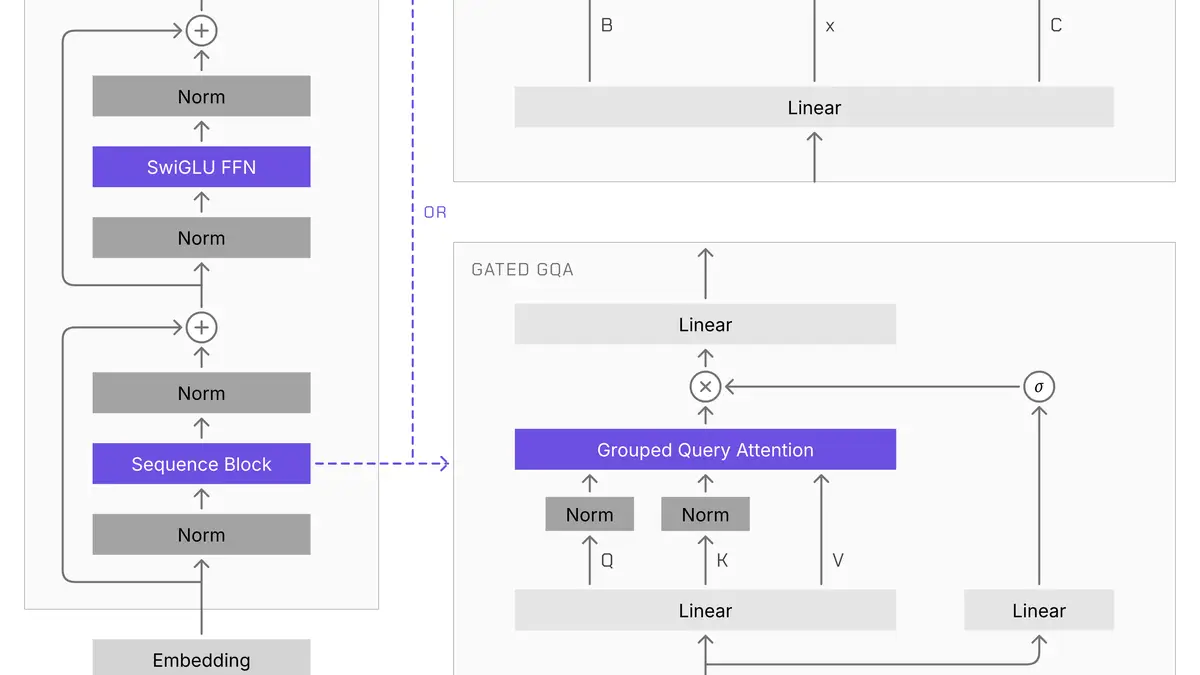
Liquid AI(リキッドAI)、2B級オープンウェイトのLFM3(エルエフエム・スリー)6モデルを公開 LFM3-1.7BはLFM2.5-2.6Bを35%少ないパラメータで上回ると同社
Liquid AI(リキッドAI)、2B級オープンウェイトのLFM3(エルエフエム・スリー)6モデルを公開LFM3-1.7BはLFM2.5-2.6Bを35%少ないパラメータで上回ると同社
モデル
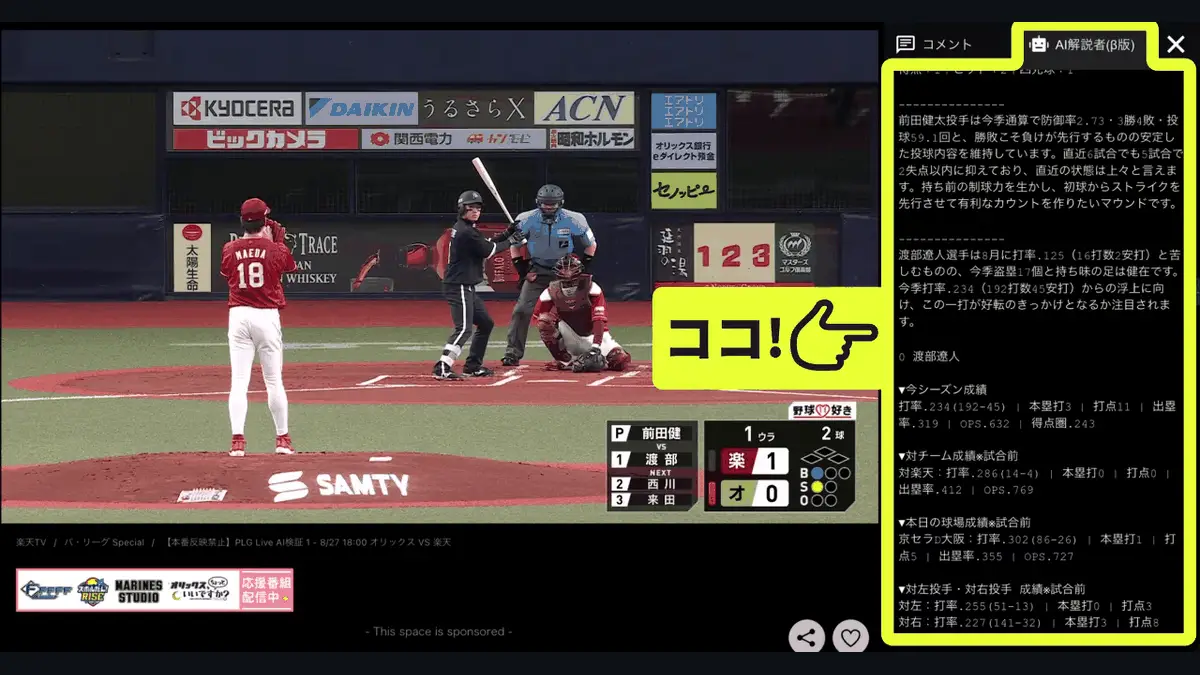
楽天、『Rakuten TV』にAI解説者(β版)・『Rakuten Music』にエージェント型AI パ・リーグ中継と音楽アプリに相次ぎ搭載
楽天、『Rakuten TV』にAI解説者(β版)・『Rakuten Music』にエージェント型AIパ・リーグ中継と音楽アプリに相次ぎ搭載
プロダクト
AWS、Amazon Polly(アマゾン ポリー)のGenerativeエンジンを更新 新ボイス14種、ヒンディー語・フィンランド語が初対応で料金とAPIは据え置き
AWS、Amazon Polly(アマゾン ポリー)のGenerativeエンジンを更新新ボイス14種、ヒンディー語・フィンランド語が初対応で料金とAPIは据え置き
プロダクト
Mistral、音声モデル群「Voxtral 3(ボクストラル)」と音声エージェントSDKを提供開始 文字起こし50言語超・音声合成35言語超、日本語も対象、$0.0035/分から
Mistral、音声モデル群「Voxtral 3(ボクストラル)」と音声エージェントSDKを提供開始文字起こし50言語超・音声合成35言語超、日本語も対象、$0.0035/分から
モデル
OpenAI、GPT-LiveにDecisions(ディシジョンズ)API連携を追加 話している最中にアプリが動き、文字起こしの差分で判断も起動
OpenAI、GPT-LiveにDecisions(ディシジョンズ)API連携を追加話している最中にアプリが動き、文字起こしの差分で判断も起動
プロダクト
OpenAI、説明文から声を作る「prompt-to-voice(プロンプト・トゥ・ボイス)」を全APIユーザーに提供 作成は無料、GPT-Liveに日本語のHaremaとShidaを含む9種の声も追加
OpenAI、説明文から声を作る「prompt-to-voice(プロンプト・トゥ・ボイス)」を全APIユーザーに提供作成は無料、GPT-Liveに日本語のHaremaとShidaを含む9種の声も追加
プロダクト
IBM、チャット・判定・音声認識を1つのエンドポイントで扱う「Granite Switch 4.1(グラナイト スイッチ)」を公開 8Bと30B、VRAMは基本モデルとほぼ同じと説明
IBM、チャット・判定・音声認識を1つのエンドポイントで扱う「Granite Switch 4.1(グラナイト スイッチ)」を公開8Bと30B、VRAMは基本モデルとほぼ同じと説明
モデル
xAI「Grok Voice 3.0」公開 第三者評価の総合指数で1位、ただし項目別では推論も会話の間合いも4位
xAI「Grok Voice 3.0」公開第三者評価の総合指数で1位、ただし項目別では推論も会話の間合いも4位
モデル
NVIDIA「Magpie TTS Multilingual」 3億6,400万パラメータのオープンウェイト音声合成が日本語を含む12言語(新たにアラビア語・韓国語・ブラジルポルトガル語)、各言語に男女の話者、日本語の混在発音と発音辞書に対応。自社基盤で動かし、最初の音声までB200で32ms・H100で47ms・DGX Sparkで53ms、64並列でも実時間の320倍
NVIDIA「Magpie TTS Multilingual」3億6,400万パラメータのオープンウェイト音声合成が日本語を含む12言語(新たにアラビア語・韓国語・ブラジルポルトガル語)、各言語に男女の話者、日本語の混在発音と発音辞書に対応。自社基盤で動かし、最初の音声までB200で32ms・H100で47ms・DGX Sparkで53ms、64並列でも実時間の320倍
検証
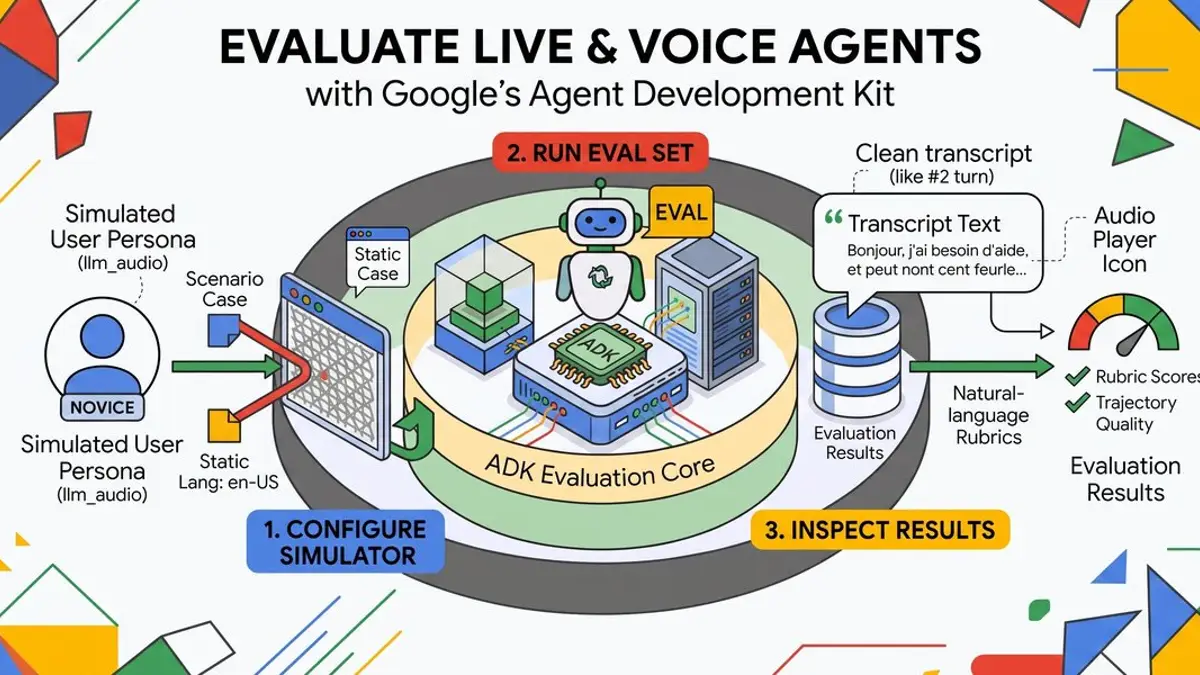
Google ADKに「ライブ・音声エージェントの評価」 模擬ユーザーがGemini TTSで話し、音声の返答をルーブリックで採点。名前確認→生年月日の検証(ツール呼び出し)→予約案内の3段ワークフローを、会話計画とペルソナ(NOVICE等)で即興させるか台本どおりに回す。test_config.jsonのlive_model_configを外せば同じケースをテキストで実行、CI/CDにも
Google ADKに「ライブ・音声エージェントの評価」模擬ユーザーがGemini TTSで話し、音声の返答をルーブリックで採点。名前確認→生年月日の検証(ツール呼び出し)→予約案内の3段ワークフローを、会話計画とペルソナ(NOVICE等)で即興させるか台本どおりに回す。test_config.jsonのlive_model_configを外せば同じケースをテキストで実行、CI/CDにも
検証
Google、Gemini 3.8 Flash TTSと3.8 Flash-Lite TTSを発表 9/15公開の3.8 Liveとは別の読み上げ専用モデル、既製の声は2,000種類超、音声出力は10秒$0.0015〜$0.00225(2026年内)
Google、Gemini 3.8 Flash TTSと3.8 Flash-Lite TTSを発表9/15公開の3.8 Liveとは別の読み上げ専用モデル、既製の声は2,000種類超、音声出力は10秒$0.0015〜$0.00225(2026年内)
モデル
Googleが「300言語超・70億人・世界人口の86%」と数字を出した言語AIの現在地 Gemini 3.5 Live Translateは70言語・2,000超の言語ペア、目標は「話者数上位1,000言語」、端末内翻訳TranslateGemmaは55言語、フィーチャーフォンでもGemini
Googleが「300言語超・70億人・世界人口の86%」と数字を出した言語AIの現在地Gemini 3.5 Live Translateは70言語・2,000超の言語ペア、目標は「話者数上位1,000言語」、端末内翻訳TranslateGemmaは55言語、フィーチャーフォンでもGemini
研究
OpenAI、全二重の音声モデル「GPT-Live-1」をAPIで提供 1分$0.05(秒単位課金)の会話層に、推論とツールはGPT-6 Astraなど後ろのモデルへ委任。Full Duplex BenchでGPT-Realtime-2.1より30ポイント上、電話(SIP)対応、声は12種類
OpenAI、全二重の音声モデル「GPT-Live-1」をAPIで提供1分$0.05(秒単位課金)の会話層に、推論とツールはGPT-6 Astraなど後ろのモデルへ委任。Full Duplex BenchでGPT-Realtime-2.1より30ポイント上、電話(SIP)対応、声は12種類
プロダクト
 動画
Alibaba、Qwen3.8-Omni-Flashを発表 音声1時間の入力が1セント未満、会議の文字起こしはDER 88.1→3.4、Gemini 3.8 Flashに音声で上・動画推論で下、重みは非公開
Alibaba、Qwen3.8-Omni-Flashを発表音声1時間の入力が1セント未満、会議の文字起こしはDER 88.1→3.4、Gemini 3.8 Flashに音声で上・動画推論で下、重みは非公開
モデル
Gemini 3.8 Liveと3.8 Live Extended Thinking公開 話しながら裏で考えて道具を動かす音声モデル、Artificial Analysisの音声対話指数で首位(9月時点)、音声は1分あたり入力$0.005・出力$0.018
Gemini 3.8 Liveと3.8 Live Extended Thinking公開話しながら裏で考えて道具を動かす音声モデル、Artificial Analysisの音声対話指数で首位(9月時点)、音声は1分あたり入力$0.005・出力$0.018
モデル
ByteDanceが「見ながら聞きながら話す」全二重AIを実運用投入 音声だけのGPT系リアルタイムAIとの違いはどこにあるか
ByteDanceが「見ながら聞きながら話す」全二重AIを実運用投入音声だけのGPT系リアルタイムAIとの違いはどこにあるか
モデル
RedNoteのdots3-noteをllama.cppがサポート 280Bのマルチモーダル、動くのは16B、Apache 2.0
RedNoteのdots3-noteをllama.cppがサポート280Bのマルチモーダル、動くのは16B、Apache 2.0
モデル
5分のフル楽曲を生成するMiniMax Music 3、重みが公開 8B+0.6Bの2段構えLLMとFlow Matchingで歌詞から曲を作る
5分のフル楽曲を生成するMiniMax Music 3、重みが公開8B+0.6Bの2段構えLLMとFlow Matchingで歌詞から曲を作る
モデル