
SpaceXAI(旧xAI)、Grok Voice Transcribe 2.0を公開同社発表は「1.0の2倍の精度」、価格は1.0と同額
日刊AIニュース11月7日(土)号:前日のAIのニュース3本を短くまとめました(約5分)›
SpaceXAI(旧xAI)は2026年9月17日付の公式リリースノートで、音声文字起こしモデル「Grok Voice Transcribe 2.0」を公開した。発表ページは「1.0の2倍の精度で価格は同じ(バッチ$0.10/時間・ストリーミング$0.20/時間)」と説明し、社内評価4種のグラフではWhisper Large v3やElevenLabs Scribe v2など5モデルと並べている。1.0からの単語誤り率の改善幅は、評価セットによって約1.5〜3.0倍(本記事の計算)。話者分離・単語単位のタイムスタンプ・最大8チャンネルの個別文字起こしに対応し、日本語を含む25言語で数字などの書式整形ができる。
目次
2026年9月25日(日本時間)に docs.x.ai と x.ai の公式ページを開いて確認した内容です。SpaceXAI(旧xAI)は、2026年9月17日付の公式リリースノートで音声文字起こしモデル「Grok Voice Transcribe 2.0」(モデル名 grok-voice-transcribe-2.0)を公開しました。9月18日付の発表ページは、実世界の音声を使った自社評価で「1.0の2倍の精度、価格は同じ」と説明しています。価格はバッチ処理が1時間あたり0.10ドル、ストリーミングが1時間あたり0.20ドルで、1.0から変わっていません。音声で会話するモデル(Think Fast 2.0、既報)とは別の、文字起こし専用のモデルです。
3行まとめ
- SpaceXAI(旧xAI)が2026年9月17日、文字起こしモデル
grok-voice-transcribe-2.0を公開。発表ページは「1.0の2倍の精度、価格は同じ」と説明(バッチ$0.10/時間・ストリーミング$0.20/時間は1.0と同額)- 発表ページの社内評価グラフ(4種)は、Gemini 3.5 Transcribe・MAI-Transcribe-2・ElevenLabs Scribe v2・Deepgram Nova-3・Whisper Large v3と比べた単語誤り率(WER)を数値つきで載せている。1.0からの改善は約1.5〜3.0倍(本記事の計算)で、4種のうち「電話番号・メール等」ではMAI-Transcribe-2のほうが低い
- 日本語は、発表ページの言語別グラフの元データで2.0のWERが2.63%(1.0は5.08%)。ただしグラフに数値ラベルは無く、評価データの名前も書かれていない。この記事では日本語音声をAPIに投げて試してはいない
9月17日のリリースノートと9月18日の発表ページ
| 項目 | 内容 |
|---|---|
| 公開日 | 2026年9月17日(xAI公式リリースノートの日付)。発表ページの表示日付は「Sep 18, 2026」、JSON-LDの公開日時は「2026-09-18T00:00:00Z」 |
| モデル名 | grok-voice-transcribe-2.0(grok-voice-transcribe-1.0も引き続き指定可能) |
| 公式の精度説明 | 「1.0の2倍の精度、価格は同じ」(発表ページ。実世界の自社評価として) |
| 公開されている改善数値 | 社内評価4種すべてで1.0よりWERが低い。短いフレーズ(音声アシスタント発話・19言語)は20.6%→6.8%、通話音声は10.6%→7.1%(いずれも発表ページのグラフ) |
| 価格 | バッチ$0.10/時間、ストリーミング$0.20/時間(発表ページ。docs.x.aiの料金表でも「$0.10 / hr (REST), $0.20 / hr (Streaming)」) |
| 対応言語(テキスト整形) | 25言語(日本語jaを含む)。docsは、languageパラメータの指定に関係なくこれらの言語の音声を文字起こしすると説明 |
| 話者分離・タイムスタンプ | 対応(話者分離はdiarize=trueで有効化)。発表ページは、話者分離・タイムスタンプ・キーターム指定が料金に含まれると説明 |
| 既存ユーザーへの影響 | 発表は「既存のSpeech-to-Text API利用はコード変更なしで精度改善を受け取れる」と説明。1.0は「今後数週間で非推奨に」、使い続けたい場合はgrok-voice-transcribe-1.0を明示指定 |
発表ページによると、2.0は音声対話の「Grok Voice」と同じ音声基盤モデルの上に作られています。
発表ページのグラフに載っていた7モデルの数字
発表ページの社内評価のグラフは、ページを開いたあとにブラウザ側で描かれる作りです。HTMLの本文を文字として読むだけでは、Whisperの名前も含めて比較対象のモデル名と数値が出てきません。筆者がページをブラウザで表示させてグラフを描画させると、横軸に7モデルが並び、棒ごとにWERの数値ラベルが付いていました。
発表ページ「Internal Evaluations」のグラフの数値(WER、%、低いほど良い。xAIの社内評価):
| モデル | 通話音声(英語・8kHz) | Grokとの会話(英語) | 電話番号・メール・住所(英語) | 短いフレーズ(19言語) |
|---|---|---|---|---|
| Grok Voice Transcribe 2.0 | 7.1 | 3.3 | 3.2 | 6.8 |
| Grok Voice Transcribe 1.0 | 10.6 | 8.7 | 7.2 | 20.6 |
| Gemini 3.5 Transcribe | 15.9 | 5.7 | 10.4 | 7.8 |
| MAI-Transcribe-2 | 9.3 | 7.0 | 2.6 | 7.2 |
| ElevenLabs Scribe v2 | 12.6 | 22.7 | 4.0 | 7.1 |
| Deepgram Nova-3 | 12.4 | 18.3 | 9.6 | 9.6 |
| Whisper Large v3 | 15.8 | 10.2 | 7.6 | 9.7 |
発表文は「4種すべてで1.0より改善し、通話音声ではテストした全モデルの中で最良」と書いており、表の数字もその通りです。4種のうち3種では2.0がもっとも低く、「電話番号・メール・住所」ではMAI-Transcribe-2(2.6%)のほうが2.0(3.2%)より低くなっています。OpenAIのWhisper Large v3は4種とも2.0より高い値です。1.0のWERを2.0のWERで割ると、通話音声で約1.5倍、会話で約2.6倍、電話番号等で約2.3倍、短いフレーズで約3.0倍になります(本記事の計算)。「2倍の精度」は、この4種を一つにまとめた数字ではありません。
第三者の比較としては、発表ページがArtificial Analysisの公開リーダーボードを挙げ、「ストリーミング部門の32モデル中で精度1位」と書いています。本記事が9月25日に取得したこのページは「31 of 37 models」と表示しており、ページのデータ上、AA-WER Streaming Indexがもっとも低いのはGrok Voice Transcribe 2.0(Streaming)の2.73%でした(1.0は3.93%)。37項目の中にはOpenAIの「GPT Realtime Whisper」(4.89%)も入っています。モデル数が「32」と合わない理由は確認していません。
一方、発表ページの同じグラフには「Batch」タブもあり、出典はArtificial Analysisの非ストリーミング部門です。そのタブの描画データでは、MAI-Transcribe-2(2.0%)とScribe v2(2.2%)が、Grok Voice Transcribe 2.0(2.3%)より低い位置にあります。非ストリーミング部門のページでも、9月25日時点で2.0の値は2.29%、MAI-Transcribe-2が2.04%、Scribe v2が2.18%でした。発表の「1位」はストリーミング部門の話です。
発表ページの価格グラフは、1時間あたりの価格としてElevenLabs Scribe v2をバッチ$0.22・ストリーミング$0.39、Deepgram Nova-3を$0.26・$0.46と並べています。これはxAIが示した他社の価格で、各社の料金ページとは突き合わせていません。
多言語・話者分離・タイムスタンプ対応
Speech to Textの公式ドキュメントによると、リクエストパラメータには次のものがあります。
diarize(真偽値・既定false):trueにすると話者分離が有効になり、レスポンスの各単語に話者番号(speaker)が付くmultichannel(真偽値)とchannels(整数、2〜8): 各チャンネルを個別に文字起こしする。docsは典型的な用途として、オペレーターをチャンネル0、顧客をチャンネル1に録音したコールセンターの音声を挙げている- レスポンスの
words配列には、単語ごとのstart・end(開始・終了時刻)が入る keyterm: 製品名や固有名詞など、文字起こしで優先させたい語句を最大100件(1件50文字まで)指定できるvad_threshold: 音声でない区間を判定するしきい値を0〜1で調整できる(0でこの判定を無効化)
発表ページの「Features」でも、「話者分離は追加料金なし」「単語ごとに開始・終了時刻と信頼度スコアが付く」「最大8チャンネルを個別に文字起こし」「1リクエストで最大100語句のキーターム」が挙がっています。多言語については、発表ページに「Grok Voice Transcribe 2.0は数十の言語を文字起こしし、言語を自動検出し、録音途中の言語切り替えにも1パスで追随する」「多言語の精度が1.0からの最大の改善点」という記述があります。
日本語の数字は、ラベルの無い棒グラフの中にあった
発表ページの「Multilingual」の節には、19言語の「Transcription accuracy」(WER)を2.0・1.0・ElevenLabs Scribe v2・Deepgram Nova-3で比べた棒グラフがあり、横軸に日本語(Japanese)が含まれています。棒に数値ラベルは付いておらず、目盛りは0〜40%です。ページが読み込むグラフ用のデータでは、日本語の値は次の通りでした。
| 日本語(Japanese) | WER(%) |
|---|---|
| Grok Voice Transcribe 2.0 | 2.63 |
| Grok Voice Transcribe 1.0 | 5.08 |
| ElevenLabs Scribe v2 | 5.02 |
| Deepgram Nova-3 | 4.57 |
このグラフについて、どの評価データで測ったかはページに書かれていません。同じデータでは19言語すべてで2.0が1.0を下回っているわけではなく、中国語(2.0が2.33%、1.0が2.10%)とフランス語(6.92%と6.01%)は1.0の値のほうが低くなっています。
ドキュメント側では、languageパラメータで指定できる言語の一覧(25言語)に日本語(ja)があります。ただしこの一覧は、数字・通貨・単位を書き言葉の形に整形する機能(format=true、Inverse Text Normalization)のための指定です。ドキュメントは、languageパラメータの値に関わらずこれらの言語の音声を文字起こしする、と説明しています。
この記事では、実際に日本語の音声ファイルをAPIに投げて確かめる作業はしていません。上の日本語の数字はxAIが自社で測った値で、第三者による検証や、筆者の環境での再現ではありません。
1.0から何が変わったと発表されたか
発表ページが明記している変更点は次の通りです。
- 精度: 「現在利用できるなかでもっとも正確な文字起こしモデルの一つで、1.0の2倍の精度」(実世界の自社評価として。価格は同じ)
- 多言語: 「1.0からの最大の改善点」と明記。短いフレーズ(音声アシスタント発話・19言語のセット)でWERが20.6%→6.8%
- 社内評価4種: 通話音声(電話回線)・Grokとの会話・口頭の認証情報(アカウントコードやメールアドレス)・短い多言語音声コマンドの4セットで、「4種すべてで1.0より改善し、通話音声ではテストした全モデルの中で最良」と説明
- 料金: 1.0と同額。既存の実装はコード変更なしで精度改善を受け取れるとしている
- 既定モデルの切り替え予定: 「Grok Voice Transcribe 2.0は近くSpeech-to-Text APIの既定モデルになり、1.0は今後数週間で非推奨になる。移行期間中に1.0を使い続けたい場合は
grok-voice-transcribe-1.0を明示的に指定すること」
3つの公式ページで割れている「既定モデル」の表記
筆者は2026年9月25日(日本時間)に、docs.x.ai と x.ai の3ページを開いて突き合わせました。「今どちらが既定(デフォルト)モデルか」の記載が一致していませんでした。
- リリースノート(September 17の項目):
"
grok-voice-transcribe-2.0is now available. Usegrok-voice-transcribe-1.0orgrok-voice-transcribe-2.0; the default isgrok-voice-transcribe-1.0."(訳:
grok-voice-transcribe-2.0が利用可能になった。grok-voice-transcribe-1.0かgrok-voice-transcribe-2.0を使う。既定はgrok-voice-transcribe-1.0)
- 発表ページ(x.ai/news/grok-voice-transcribe-2):
"Grok Voice Transcribe 2.0 will soon be the default in the Speech-to-Text API, and Grok Voice Transcribe 1.0 will be deprecated in the coming weeks."
(訳:Grok Voice Transcribe 2.0は近くSpeech-to-Text APIの既定になり、Grok Voice Transcribe 1.0は今後数週間で非推奨になる)
- Speech to Textのドキュメント(モデル選択の表):
grok-voice-transcribe-2.0の行に
"Our best transcription model. Default when
modelis omitted."(訳:当社で最良の文字起こしモデル。
modelを省略したときの既定)
同じページのパラメータ表でも、modelの既定値欄はgrok-voice-transcribe-2.0になっています(バッチ・ストリーミングとも)。
つまり、同じ日に確認した3つの公式ページのうち、リリースノートは「1.0が既定」、発表ページは「2.0は近く既定になる」、ドキュメントは「2.0がすでに既定」と読める書き方です。実際の挙動はAPIを実行して確かめていないため、この記事では判断せず、記載の食い違いだけを記録します。modelパラメータを省略して呼び出している既存の実装がある場合、この食い違いは実害になりえます。発表ページ自身も、移行期間中に1.0を使い続けたい場合はgrok-voice-transcribe-1.0を明示指定するよう書いています。
APIは呼ばずに、ページだけで確かめた範囲
本文で名指しした一次情報は frontmatter の sources にすべて記載しています。価格($0.10/時間・$0.20/時間)は発表ページとdocs.x.aiの料金表の2か所で一致しました。社内評価の7モデルの数値と価格グラフの他社価格は、発表ページをブラウザで描画したときに表示された数値ラベルです。日本語など言語別のWERと、Batchタブの値は、グラフに数値ラベルが無いため、ページが読み込むグラフ用データから読みました。Artificial Analysisの値は、9月25日に取得した同社ページのデータです。APIの呼び出しと、日本語音声での実地テストは行っていません。
出典・参照資料
- 一次資料Release Notes(September) — xAI公式ドキュメント ↗
- 一次資料Introducing Grok Voice Transcribe 2.0 — SpaceXAI公式発表 ↗
- 一次資料Speech to Text — xAI公式ドキュメント(モデル選択・言語・料金) ↗
- 一次資料API Pricing — xAI公式ドキュメント ↗
- 二次資料Speech to Text (Streaming) — Artificial Analysis(第三者ベンチマーク・xAI発表がリンク先として引用) ↗
- 二次資料Speech to Text (Non-streaming) — Artificial Analysis(xAI発表のBatchタブの出典) ↗
大きいニュースはYouTubeでも解説しています。Xでは新着記事をお知らせしています。
コメント
まだコメントはありません。最初のコメントを書いてみませんか?
AIについて聞きたいことはありますか?
質問箱で無料で受け付けています。回答は公開され、他の方の参考にもなります。
質問箱を見る →関連記事
grok-voice-latestが裏側でThink Fast 2.0に切り替わった日 8月5日、気づかれずに起きたルーティング変更
grok-voice-latestが裏側でThink Fast 2.0に切り替わった日8月5日、気づかれずに起きたルーティング変更
 動画
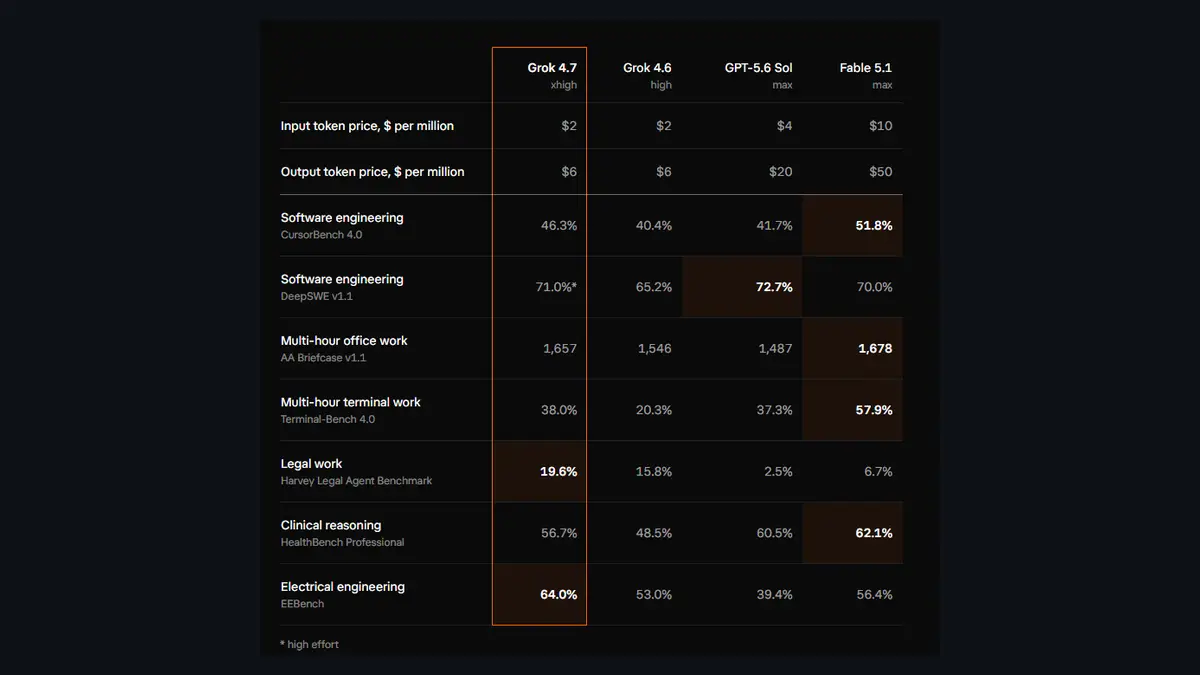
SpaceXAIがGrok 4.7を公開 価格は4.6と同じ2ドル/6ドルのまま、公式表7項目で対Fable 5.1は3勝4敗・対GPT-5.6 Solは5勝2敗
SpaceXAIがGrok 4.7を公開価格は4.6と同じ2ドル/6ドルのまま、公式表7項目で対Fable 5.1は3勝4敗・対GPT-5.6 Solは5勝2敗
Grokとは──無料でできること、SuperGrok 4プラン(月10〜300ドル)とX Premium+の関係
Grokとは──無料でできること、SuperGrok 4プラン(月10〜300ドル)とX Premium+の関係
xAI「Grok Voice 3.0」公開 第三者評価の総合指数で1位、ただし項目別では推論も会話の間合いも4位
xAI「Grok Voice 3.0」公開第三者評価の総合指数で1位、ただし項目別では推論も会話の間合いも4位
grok-imagine-video-1.5がネイティブ1080p対応に text-to-videoは内部で2段階処理という仕組み
grok-imagine-video-1.5がネイティブ1080p対応にtext-to-videoは内部で2段階処理という仕組み
xAI、コスト効率型『Grok 4.3』と専用コーディングモデル『Grok Build 0.1』を投入
xAI、コスト効率型『Grok 4.3』と専用コーディングモデル『Grok Build 0.1』を投入
 動画
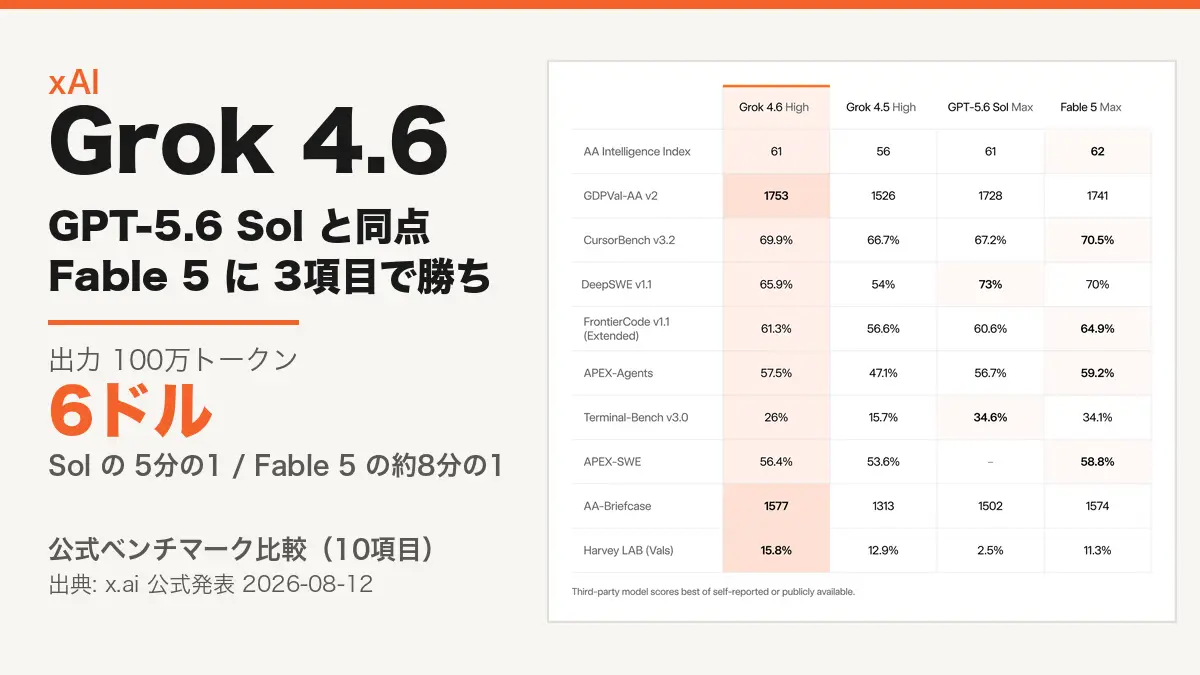
xAIがGrok 4.6を公開 GPT-5.6 Solと同点、出力価格は6ドルで5分の1
xAIがGrok 4.6を公開GPT-5.6 Solと同点、出力価格は6ドルで5分の1
 動画