xAI「Grok Voice 3.0」公開第三者評価の総合指数で1位、ただし項目別では推論も会話の間合いも4位
日刊AIニュース10月17日(土)号:前日のAIのニュース17本を短くまとめました(約8分)›
xAI(開発者向けの表記はSpaceXSI)は2026年10月14日、音声対話モデル「Grok Voice 3.0」を公開した。公式ブログによるとArtificial Analysisの総合指数で86.9点の1位、料金はGrok Voice 2.0と同じ1分0.08ドル。ただし同社の表を項目別に並べ直すと、推論と会話の間合いは4位、人による聞き比べは3位タイで、最初の声が出るまでの時間は2.0より長かった。
目次
10月15日更新: 公開した時点(日本時間10月15日1時台)は、APIのリリースノートと料金ページだけを基にしていました。その後に出たxAIの公式ブログと、Artificial Analysis・ServiceNow が公開している評価表を加えて、全体を書き直しています。
xAI(開発者向けドキュメントの表記は「SpaceXSI」)は2026年10月14日(米国時間)、音声を入れると音声で返す対話モデル「Grok(グロック)Voice 3.0」を公開しました。公式ブログは「the world’s most intelligent speech-to-speech model」(世界で最も賢い音声対話モデル)とうたい、第三者の評価機関 Artificial Analysis の総合指数で86.9点の1位になったと書いています。API料金は Grok Voice 2.0 と同じ1分0.08ドルで、grok-voice-latest を指定しているアプリは自動で3.0に切り替わりました。
3行まとめ
- xAIは10月14日、音声対話モデル Grok Voice 3.0 を公開。公式ブログによると Artificial Analysis の総合指数で86.9点の1位、料金は2.0と同じ1分0.08ドル
- ただし Artificial Analysis の表を項目別に並べ直すと、推論と会話の間合いは4位、人による聞き比べは3位タイ。最初の声が出るまでの0.81秒は、2.0の0.70秒より長い
- ServiceNow の EVA-Bench の表では、精度の合格率0.737で掲載システム中1位。会話の体験の点では Gemini 3.8 Live などが上
本記事の数字は、日本時間2026年10月15日10時台に各ページを取得して確かめたものです。
xAIが出した比較表
公式ブログの比較表(出典は Artificial Analysis、10月13日時点)は次のとおりです。
| 項目 | Grok Voice 3.0 | Grok Voice 2.0 | GPT-Live-1(Astra, Medium) | Gemini 3.8 Live(Ext. Thinking, High) |
|---|---|---|---|---|
| 総合指数(AA Speech-to-Speech Index) | 86.9 | 81.3 | 83.2 | 82.6 |
| 推論(Big Bench Audio) | 98.5% | 97.2% | 90.1% | 97.7% |
| 人の好み(Speech Agent Arena Elo) | 1070 | 1011 | 1048 | 990 |
| タスク完了率(Task Success Rate) | 94.8% | 94.6% | 87.4% | 89.1% |
| 会話の間合い(Full Duplex Bench) | 97.0% | 95.1% | 94.9% | 91.9% |
この4列の中では、Grok Voice 3.0 がすべての項目で一番上です。ブログはほかに、次の数字を挙げています。
- 電話サポートを模したテスト τ-Voice(タウ・ボイス)は71.6%。GPT-Live-1(Astra)の74.5%より低いものの、応答の遅れは40%少ない(「at 40% lower latency」)としている
- Artificial Analysis の Big Bench Audio を1問解く費用の平均は0.025ドル。GPT-Live-1(Astra, Medium)の0.030ドル、GPT-Realtime-2.1(High)の0.055ドルを下回る
- ServiceNow の企業向け音声エージェント評価 EVA-Bench で、精度は最も高い74%
ServiceNow でプロダクトマネジメントを担当するシニアディレクター、Nitin Aggarwal 氏のコメントも載っています。
Grok Voice 3.0 sets a new Pareto frontier on EVA-Bench, ServiceNow’s open-source benchmark scoring voice agents on accuracy and experience across 200+ realistic enterprise scenarios.
(Grok Voice 3.0 は、200以上の現実的な企業シナリオで音声エージェントの精度と体験を採点する ServiceNow のオープンソースのベンチマーク EVA-Bench で、新しいパレートフロンティアを打ち立てた。)
Artificial Analysis も公式Xで、Grok Voice 3.0 について「debuting at #1 on the Artificial Analysis Speech to Speech Index at 86.9」(総合指数86.9で1位に初登場)と投稿しています。
Artificial Analysisの表を項目別に並べ直すと
公式の比較表に並んでいるのは、OpenAI と Google の一部の版だけです。Artificial Analysis のページには40以上のモデルが載っています。筆者が10月15日にこのページの一覧表を取得し、項目ごとに並べ直すと次のようになりました。
| 項目 | Grok Voice 3.0 | 順位(値があるモデルの数) | 1位 |
|---|---|---|---|
| 総合指数 | 86.9 | 1位(19) | Grok Voice 3.0 |
| 推論(Big Bench Audio) | 98.5% | 4位(41) | StepAudio 3 Realtime(99.7%) |
| 会話の間合い(Full Duplex Bench) | 97.0% | 4位(35) | StepAudio 3 Realtime(98.9%) |
| 電話サポート(τ-Voice) | 71.6% | 2位(26) | GPT-Live-1(Astra, medium)(74.5%) |
| 人の好み(Arena Elo) | 1070 | 3位タイ(22) | Gemini 3.1 Flash Live Minimal(1100) |
| タスク完了率 | 94.8% | 1位(22) | Grok Voice 3.0 |
| 最初の声が出るまで | 0.81秒 | 7位タイ(37) | Raon SpeechChat(0.04秒) |
推論と会話の間合いの順位は、同じページの「よくある質問」でも上位5つの4番目に Grok Voice 3.0 が挙がっています。人の好みは、Gemini 3.1 Flash Live Minimal(1100)と Gemini 3.8 Live の標準版(1088)が上で、Gemini 3.1 Flash Live High と同じ1070です。
総合指数で1位なのに項目別では1位でないものが多いのは、指数の作り方によります。Artificial Analysis の説明では、総合指数は推論・τ-Voice・人の好み・タスク完了率の4つを同じ重みで平均したもので、4つ全部の結果があるモデルにだけ付きます。推論と会話の間合いで1位の StepAudio 3 Realtime は τ-Voice などの結果が無く、指数が付いていません。会話の間合いと応答の速さは、そもそも指数に入っていません。
最初の声が出るまでは2.0より長い
Artificial Analysis の表で、最初の声が出るまでの時間は Grok Voice 3.0 が0.81秒、2.0が0.70秒です。公式ブログの「class-leading latency at under one second」(1秒を切るトップクラスの応答の速さ)は、GPT-Live-1(Astra, medium)の1.34秒や Gemini 3.8 Live(Extended Thinking, High)の1.35秒と比べれば当てはまります。ただ同じ表には0.81秒より速いモデルが6つあり、その1つは前作の Grok Voice 2.0 です。「40%少ない」は、GPT-Live-1(Astra)の1.34秒と比べた数字(0.81÷1.34≒0.60)と計算が合います。
費用は比較表のGeminiの方が低い
公式ブログの費用の図で、Grok Voice 3.0 と並べられている相手は GPT-Live-1 と GPT-Realtime-2.1 だけです。Artificial Analysis の表の「入力音声1時間あたりの費用」(Big Bench Audio の40問を解く費用を、入力音声1時間あたりに直したもの)は次のとおりでした。
| モデル | 入力音声1時間あたりの費用 |
|---|---|
| Gemini 3.8 Live | 0.84ドル |
| Gemini 3.8 Live(Extended Thinking, High) | 3.50ドル |
| Grok Voice 3.0 | 4.80ドル |
| GPT-Live-1(Astra, medium) | 5.83ドル |
| GPT-Realtime-2.1 High | 10.75ドル |
公式の比較表に載っている Gemini の版でも、この指標では Grok Voice 3.0 より低くなります。公式ブログの1問あたりの費用(0.025ドルと0.030ドル)は、この表の4.80ドルと5.83ドルとほぼ同じ比率で、同じ測定から出た数字とみられます(筆者の計算による推測)。
ServiceNowのEVA-Benchの表では
公式ブログの「EVA-Bench で精度74%」を、ServiceNow が公開している EVA の結果ページの数値と照らし合わせました。このページのデータで、Grok Voice 3.0 の精度(EVA-A)の合格率は0.737です。数値が載っている23のシステムの中で最も高く、ブログの74%とも一致します。
一方、会話の体験(EVA-X)の合格率では、Grok Voice 3.0 は0.712で5番目でした。
| システム | 精度(EVA-A) | 体験(EVA-X) |
|---|---|---|
| Grok Voice 3.0 | 0.737 | 0.712 |
| Scribe v2.2 Realtime+GPT-5.4+Eleven Flash v2(ElevenAgents) | 0.672 | 0.130 |
| GPT Realtime 2.1 | 0.590 | 0.616 |
| Gemini 3.8 Live(Extended Thinking, High) | 0.548 | 0.737 |
| Grok Voice 2.0 | 0.517 | 0.641 |
| Gemini 3.8 Live | 0.459 | 0.886 |
| Scribe v2.2 Realtime+Claude Haiku 4.5+Eleven Flash v2(ElevenAgents) | 0.410 | 0.817 |
精度の上位と体験の上位が別のシステムに分かれる中で、両方を高い水準でそろえたのが Grok Voice 3.0 だ、というのが「パレートフロンティア」という言い方の中身だと筆者は読んでいます(解釈)。なお、今回取得したデータに OpenAI の GPT-Live-1 の行はありません。比べられている OpenAI のモデルは GPT Realtime 2.1 などです。また EVA のページは今後の予定に「Expand to Multilingual」(英語以外への拡張)を挙げており、今の結果は英語のシナリオによるものです。
テスラとStarlinkでの使われ方(xAIの説明)
公式ブログは、自社グループでの使われ方を次のように説明しています。
- テスラの車内で1日に数百万件の会話を処理している。Connectors でカレンダーの確認やメールの返信を、Grok Bot でコーヒーの注文や夕食の予約を、手を使わずに頼める
- Grok Bot の音声モードも Grok Voice 3.0 で動いている
- Starlink のコールセンターでは、Grok Voice が複数の言語で1日2万件の電話に応対し、約70%は人が入らずに解決する。営業の電話は4件に1件が、電話を切る前に購入まで進む
- Grok Voice 3.0 で作った1つのエージェントが、本人確認、機器のトラブル対応、クレジットの発行、交換機器の発送までこなす
件数・解決率・購入率はいずれも xAI 自身の説明で、本記事では第三者による数字を確かめられていません。
開発者が変えること
xAIの Speech to Speech のドキュメントには、2.0からの移行について次のように書かれています。
The API is unchanged: Grok Voice 3.0 uses the same endpoint, session parameters, and events as Grok Voice 2.0, at the same price.
(APIは変わりません。Grok Voice 3.0 は Grok Voice 2.0 と同じエンドポイント、セッションの設定、イベントを使い、価格も同じです。)
grok-voice-latestを指定している場合は、すでに3.0で動いているgrok-voice-2.0を名指しで指定している場合は、非推奨になったので model をgrok-voice-3.0に変える- 料金ページの表記は、grok-voice-3.0 が「$0.08 / min($4.80 / hr)」と「$0.004 / text input」。grok-voice-2.0 も同額で「Deprecated」と付いている
- 対応言語は20以上で、日本語(ja)も入っている。話した言語を自動で判定して、同じ言語で返す
- 2.0の廃止日は、今回取得したリリースノートと Speech to Speech のページには書かれていない
リリースノートから、音声まわりの最近の動きを並べます。
| 日付(リリースノートの表記) | 内容 |
|---|---|
| 2026年7月29日 | grok-voice-2.0 が Speech to Speech で利用可能に。grok-voice-latest は8月5日から2.0を指すと予告 |
| 2026年9月17日 | 音声認識の grok-voice-transcribe-2.0 が利用可能に |
| 2026年10月2日 | grok-voice-transcribe-1.0 が終了し、リクエストは2.0に同額でつなぎ替え |
| 2026年10月14日 | grok-voice-3.0 が利用可能に。grok-voice-2.0 は非推奨 |
2.0のときは「8月5日から latest が2.0を指す」と1週間前に予告がありましたが、3.0は公開と同じ日に latest の向き先が変わっています。2.0への切り替えが裏側でどう起きたかは、grok-voice-latest が Think Fast 2.0 に切り替わった日の記事で扱いました。本番で grok-voice-latest を使っている場合は、話し方や応答の長さが変わっていないか、自分の環境で確かめておく必要があります。
Grokアプリの音声モードも3.0なのか
公式ブログと公式Xの投稿が Grok Voice 3.0 の使われ先として挙げているのは、API と Voice Agent Builder、テスラの車内、Grok Bot の音声モードです。X の有料プランなどで使える Grok アプリの音声モードが3.0になったという記載は、本記事が確認したこれらのページにはありませんでした。iOS の Grok アプリは10月13日に版1.4.53が出ていますが、App Store の更新内容は「Improvements to Chat, Voice and Imagine」(チャット、音声、Imagine の改善)の1行だけです。アプリの音声で試して「これが3.0」と受け取るのは、今の時点では言い切れません。
公式の表と元データを突き合わせて分かったこと
筆者は公式ブログの数字を、Artificial Analysis と ServiceNow が公開している元の表と1つずつ照らし合わせました。
Grok Voice 3.0 自身の数字は、どれも元の表と一致しました。総合指数86.9、人の好み1070、タスク完了率94.8%、会話の間合い97.0%、τ-Voice 71.6%は Artificial Analysis の表と同じで、推論の98.5%は表では99%と丸めて表示され、よくある質問の文では98.5%と書かれています。EVA-Bench の74%も、EVA のデータの0.737と合っています。比べる相手の値は少しずれていて、GPT-Live-1(Astra)の Elo は公式ブログの1048に対して筆者の取得時は1056、Gemini 3.8 Live(Ext. Thinking, High)は990に対して993でした。公式ブログは10月13日時点の値としており、日付の違いによるものかは確かめられていません。
違っていたのは数字ではなく、並べる相手の選び方です。公式の比較表と費用の図には、推論と会話の間合いで上に来る StepAudio 3 Realtime と Qwen 系、人の好みで上に来る Gemini 3.1 Flash Live と Gemini 3.8 Live の標準版、費用で下回る Gemini は入っていません。総合指数の1位は事実ですが、「何でも一番」と読める比較表ではありません。
日本語の出来と使い心地はまだ分からない
- 筆者は Grok Voice 3.0 を実際には動かしておらず、話し方の自然さや日本語の聞き取りは評価していません
- 今回見た評価表(Artificial Analysis と EVA)には、言語別の点数がありません。EVA は今のところ英語のシナリオです
- 10月15日午前の時点で、実際に使った第三者の詳しいレビューは見つけられませんでした。出ている報道(SiliconANGLE など)は、公式ブログの数字を伝えるものが中心です
- 総合指数のライバルの比較は、Gemini 3.8 Live の記事とGPT-Live-1 の記事も参考になります。いずれも公開時点の内容で、Gemini 3.8 Live の記事にある「総合指数で首位」は9月時点の順位です
数字を取ったページと時刻
- Introducing Grok Voice 3.0(xAI 公式ブログ) — 2026年10月14日付。日本時間10月15日10時台に取得
- Speech to Speech(xAI 公式ドキュメント) — 移行の案内・対応言語。同上
- Pricing(xAI 公式ドキュメント) — grok-voice-3.0 の料金。同上
- Release Notes(xAI 公式ドキュメント) — 10月14日の2項目。同上(ページ末尾の最終更新表示は「October 13, 2026」のまま)
- SpaceXSI 公式Xの投稿 — 2026年10月14日 17時04分(UTC)
- Artificial Analysis の Speech to Speech のページ — 一覧表とよくある質問。日本時間10月15日10時台に取得
- Artificial Analysis 公式Xの投稿 — 2026年10月14日 17時26分(UTC)
- EVA(ServiceNow) — 結果の表。日本時間10月15日10時台に取得
- Grok AI(App Store) — 版1.4.53の更新内容
本記事は続報があり次第更新します。
この記事でよく聞かれること
- Grok Voice 3.0とは何ですか?
- xAI(開発者向けの表記はSpaceXSI)が2026年10月14日に公開した音声対話モデルです。音声を入れると音声で返します。APIでの名前は grok-voice-3.0 で、grok-voice-latest も3.0を指すようになりました。公式ブログは、第三者の評価機関 Artificial Analysis の総合指数で86.9点の1位になったと書いています。
- Grok Voice 3.0の料金はいくらですか?
- xAIの料金ページでは、grok-voice-3.0 の音声対話は1分0.08ドル(1時間4.80ドル)で、Grok Voice 2.0 と同じです。同じ欄には「$0.004 / text input」というテキスト入力の料金も載っています。
- 本当に一番性能が高いのですか?
- Artificial Analysis の総合指数では1位です。ただし同社の表を項目別に見ると、推論(Big Bench Audio)と会話の間合い(Full Duplex Bench)は4位、電話サポートを模したテスト τ-Voice は2位、人による聞き比べ(Arena)は3位タイでした。総合指数は推論・τ-Voice・人の好み・タスク完了率の4項目を同じ重みで平均したもので、会話の間合いと応答の速さは入っていません。
- 日本語で使えますか?
- xAIの Speech to Speech のドキュメントは、対応する20以上の言語に日本語(ja)を挙げ、話した言語を自動で判定して同じ言語で返すと書いています。日本語での精度を測った点数は、本記事が見た評価表(Artificial Analysis と ServiceNow の EVA)にはありません。
- Grokアプリの音声モードもGrok Voice 3.0になりましたか?
- 公式ブログが挙げている使われ先は、API、テスラの車内、Grok Bot の音声モードです。Grokアプリの音声モードが3.0になったという記載は、本記事が確認した公式ブログと公式Xの投稿にはありませんでした。iOS版の10月13日の更新内容は「Improvements to Chat, Voice and Imagine」だけです。
- grok-voice-2.0を使っている場合はどうすればいいですか?
- 2.0は非推奨になりました。xAIのドキュメントは、model を grok-voice-3.0 に変えるよう案内しています。エンドポイント、セッションの設定、イベントは2.0と同じで、価格も同じです。grok-voice-latest を使っている場合は、すでに3.0で動いています。
出典・参照資料
- 一次資料Introducing Grok Voice 3.0 — xAI(SpaceXSI)公式ブログ ↗
- 一次資料Speech to Speech | SpaceXSI Docs — xAI公式 ↗
- 一次資料Pricing | SpaceXSI Docs — xAI公式 ↗
- 一次資料Release Notes | SpaceXSI Docs — xAI公式 ↗
- 一次資料SpaceXSI公式Xの投稿(API と Voice Agent Builder で提供) ↗
- 二次資料Speech to Speech AI Model & Provider Leaderboard — Artificial Analysis ↗
- 二次資料Artificial Analysis公式Xの投稿(Grok Voice 3.0 の評価) ↗
- 二次資料EVA: A New End-to-end Framework for Evaluating Voice Agents — ServiceNow ↗
- 二次資料Grok Voice 3.0 from SpaceXSI outscores OpenAI and Google on speech-to-speech index — SiliconANGLE ↗
- 二次資料Grok AI — App Store(iOS版の更新内容) ↗
大きいニュースはYouTubeでも解説しています。Xでは新着記事をお知らせしています。
コメント
まだコメントはありません。最初のコメントを書いてみませんか?
AIについて聞きたいことはありますか?
質問箱で無料で受け付けています。回答は公開され、他の方の参考にもなります。
質問箱を見る →関連記事
Gemini 3.8 Liveと3.8 Live Extended Thinking公開 話しながら裏で考えて道具を動かす音声モデル、Artificial Analysisの音声対話指数で首位(9月時点)、音声は1分あたり入力$0.005・出力$0.018
Gemini 3.8 Liveと3.8 Live Extended Thinking公開話しながら裏で考えて道具を動かす音声モデル、Artificial Analysisの音声対話指数で首位(9月時点)、音声は1分あたり入力$0.005・出力$0.018
OpenAI、全二重の音声モデル「GPT-Live-1」をAPIで提供 1分$0.05(秒単位課金)の会話層に、推論とツールはGPT-6 Astraなど後ろのモデルへ委任。Full Duplex BenchでGPT-Realtime-2.1より30ポイント上、電話(SIP)対応、声は12種類
OpenAI、全二重の音声モデル「GPT-Live-1」をAPIで提供1分$0.05(秒単位課金)の会話層に、推論とツールはGPT-6 Astraなど後ろのモデルへ委任。Full Duplex BenchでGPT-Realtime-2.1より30ポイント上、電話(SIP)対応、声は12種類
grok-voice-latestが裏側でThink Fast 2.0に切り替わった日 8月5日、気づかれずに起きたルーティング変更
grok-voice-latestが裏側でThink Fast 2.0に切り替わった日8月5日、気づかれずに起きたルーティング変更
 動画
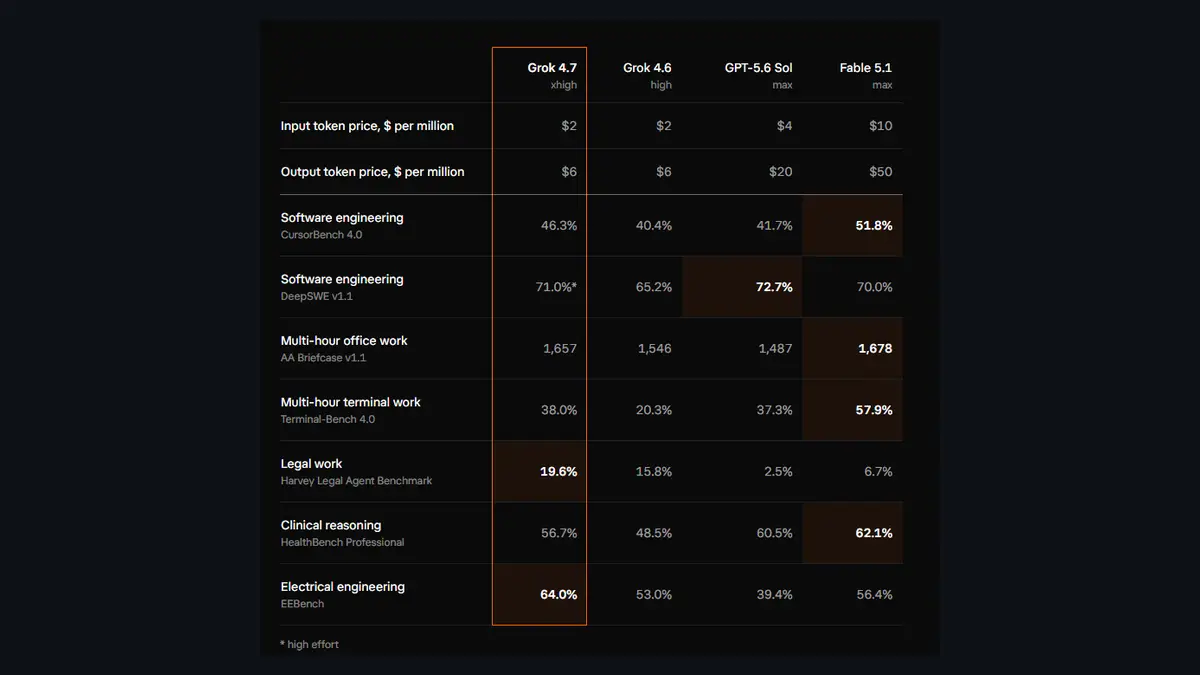
SpaceXAIがGrok 4.7を公開 価格は4.6と同じ2ドル/6ドルのまま、公式表7項目で対Fable 5.1は3勝4敗・対GPT-5.6 Solは5勝2敗
SpaceXAIがGrok 4.7を公開価格は4.6と同じ2ドル/6ドルのまま、公式表7項目で対Fable 5.1は3勝4敗・対GPT-5.6 Solは5勝2敗
 動画
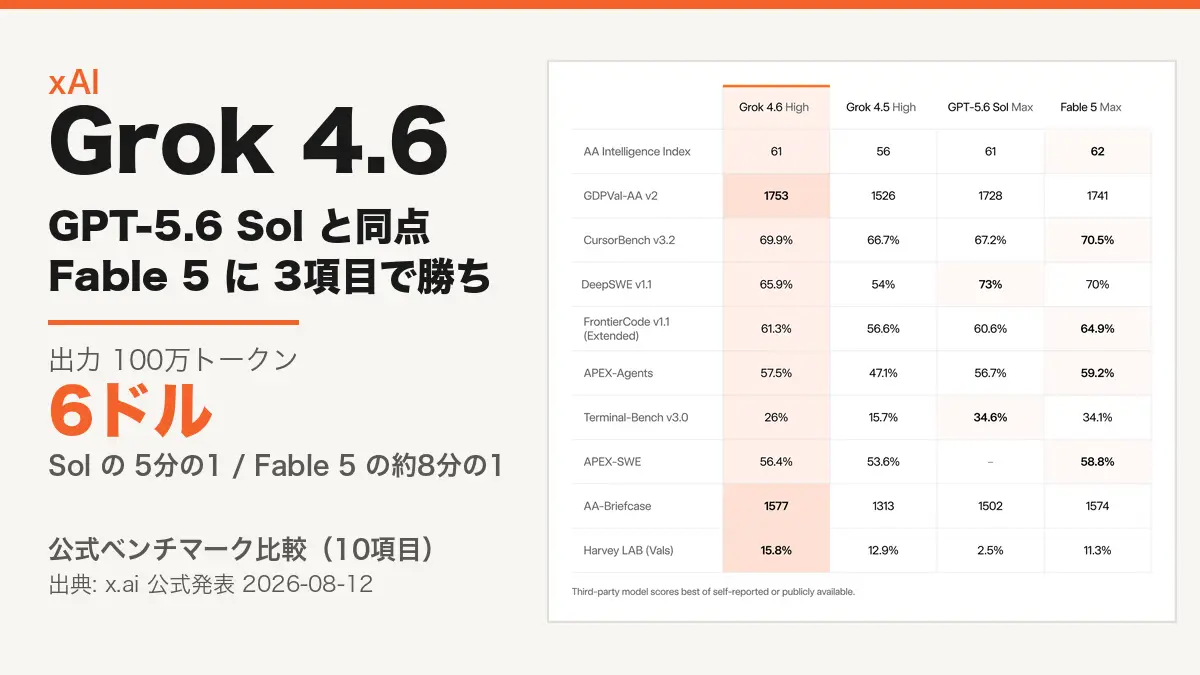
xAIがGrok 4.6を公開 GPT-5.6 Solと同点、出力価格は6ドルで5分の1
xAIがGrok 4.6を公開GPT-5.6 Solと同点、出力価格は6ドルで5分の1
 動画
xAI、Grok 4.5を発表 ベンチ1位はゼロだがトークン効率4.2倍・入力$2出力$6で別の土俵へ
xAI、Grok 4.5を発表ベンチ1位はゼロだがトークン効率4.2倍・入力$2出力$6で別の土俵へ
Grok(グロック)のログイン方法 公式サイトgrok.comの右上「サインイン」から、Xのアカウントでも入れる。無料で使え、画面は日本語。入れない時の直し方【2026年10月版】
Grok(グロック)のログイン方法公式サイトgrok.comの右上「サインイン」から、Xのアカウントでも入れる。無料で使え、画面は日本語。入れない時の直し方【2026年10月版】