
AIの安全性の記事
「AIの安全性」に関連するAIニュースと解説、96本。新しい順に並べています。
AIの安全性 の記事:96件
 動画
AIを「SI(超知能)」と呼べ トランプ大統領の改名令と「超知能協定」、名前は変わっても定義は今のAIのまま
AIを「SI(超知能)」と呼べトランプ大統領の改名令と「超知能協定」、名前は変わっても定義は今のAIのまま
業界
Ai2「BenchMIRT」 100のLLM×16ベンチマーク×3.4万問の結果を多次元の項目反応理論で分解し、教えていないのに「安全性」と「一般推論」の2軸を毎回復元。バイアス評価のBBQは安全性より推論と相関、危険知識のWMDPは推論が強いほど低得点、HarmBenchの著作権問題は安全性と相関しない。問題を10%残すだけで順位がほぼ保たれ、未見問題の正誤予測は79%(平均点方式70%)
Ai2「BenchMIRT」100のLLM×16ベンチマーク×3.4万問の結果を多次元の項目反応理論で分解し、教えていないのに「安全性」と「一般推論」の2軸を毎回復元。バイアス評価のBBQは安全性より推論と相関、危険知識のWMDPは推論が強いほど低得点、HarmBenchの著作権問題は安全性と相関しない。問題を10%残すだけで順位がほぼ保たれ、未見問題の正誤予測は79%(平均点方式70%)
検証
 動画
GPT-6.1 Solが登場 値段はGPT-6 Solのまま、公式グラフの点で読むとAstraに並んだのはコーディングとPDF読み、科学研究は11ポイント差
GPT-6.1 Solが登場値段はGPT-6 Solのまま、公式グラフの点で読むとAstraに並んだのはコーディングとPDF読み、科学研究は11ポイント差
モデル
OpenAIの「dots」とは ChatGPTの中で24時間動くエージェントの始め方・対象プラン・日本での提供・発売時点でできないこと
OpenAIの「dots」とはChatGPTの中で24時間動くエージェントの始め方・対象プラン・日本での提供・発売時点でできないこと
プロダクト
 動画
Claude Sonnet 5.5が登場 価格はSonnet 5と同じ2ドル・10ドル、同額のGPT-6 Solと比べられる4項目中3項目で上回る
Claude Sonnet 5.5が登場価格はSonnet 5と同じ2ドル・10ドル、同額のGPT-6 Solと比べられる4項目中3項目で上回る
モデル
Anthropic、Claudeが実在の第三者システムに無断アクセスした4件のアラインメント評価 4億8,100万件の記録を再走査して2026年1月のOpus 4.6初期版の1件を発見。Mythos 5はPyPIに悪性パッケージを公開し、導入した15システムの1つから実在企業のDBへ。「偏った推論」と「無謀さ」を認定し7月の「操作上の失敗」を撤回、METRが8週間の独立調査
Anthropic、Claudeが実在の第三者システムに無断アクセスした4件のアラインメント評価4億8,100万件の記録を再走査して2026年1月のOpus 4.6初期版の1件を発見。Mythos 5はPyPIに悪性パッケージを公開し、導入した15システムの1つから実在企業のDBへ。「偏った推論」と「無謀さ」を認定し7月の「操作上の失敗」を撤回、METRが8週間の独立調査
検証
Anthropic「自動化された研究者がアラインメントの失敗を確実に緩和できる」 Claudeが10種類の失敗(欺瞞・追従・脱獄・プライバシー侵害など)を探索→提案→訓練→評価のループで直し、非公開評価や4.7倍大きいモデルでも有効。欺瞞では人間の最良案より20%良い。Sonnet 5がOpus 4.8初期版を60時間・2,000例で本番並みに整え、本番手順の約1万5千倍効率
Anthropic「自動化された研究者がアラインメントの失敗を確実に緩和できる」Claudeが10種類の失敗(欺瞞・追従・脱獄・プライバシー侵害など)を探索→提案→訓練→評価のループで直し、非公開評価や4.7倍大きいモデルでも有効。欺瞞では人間の最良案より20%良い。Sonnet 5がOpus 4.8初期版を60時間・2,000例で本番並みに整え、本番手順の約1万5千倍効率
検証
AnthropicのFrontier Red Team、「標的の特定」と「通常兵器の開発」の能力評価を公開 写真の位置特定でMythos PreviewとMythos 5は中央値37.0km・47.2kmとGeoGuessr最上位層(151km)を上回る、投稿文からの自宅推定は中央値20〜31km、3.7万語の分析を約11分。模擬ドローンの誘導もコードで改善
AnthropicのFrontier Red Team、「標的の特定」と「通常兵器の開発」の能力評価を公開写真の位置特定でMythos PreviewとMythos 5は中央値37.0km・47.2kmとGeoGuessr最上位層(151km)を上回る、投稿文からの自宅推定は中央値20〜31km、3.7万語の分析を約11分。模擬ドローンの誘導もコードで改善
検証
AnthropicのFrontier Red Team「マルチエージェントシステムのパターンと問題」 45体の協調群は脆弱性266件(独立並列は21件)だが核心部分の効率は同等。30体中18体が同名ブランチ、価格ゲームは3ラウンド目に談合。3体に別言語への移行を命じると「縄張り争い」で互いのアカウントを停止し妨害スクリプトを配備、Sonnet 5だけが共有と高いマージ率を両立
AnthropicのFrontier Red Team「マルチエージェントシステムのパターンと問題」45体の協調群は脆弱性266件(独立並列は21件)だが核心部分の効率は同等。30体中18体が同名ブランチ、価格ゲームは3ラウンド目に談合。3体に別言語への移行を命じると「縄張り争い」で互いのアカウントを停止し妨害スクリプトを配備、Sonnet 5だけが共有と高いマージ率を両立
検証
 動画
米控訴裁、国防総省によるClaudeの締め出しを2対1で容認 判決文で読む「問われるのは何をするかで、なぜではない」
米控訴裁、国防総省によるClaudeの締め出しを2対1で容認判決文で読む「問われるのは何をするかで、なぜではない」
業界
 動画
OpenAI、研究環境のエージェントがユーザーの画像53件を画像共有サイトに上げていたと公表 2日前にはTransluceが「政府サイトを含む3か所へのハッキングの試み」を報告。7月からの事故記録ページと並べて読む
OpenAI、研究環境のエージェントがユーザーの画像53件を画像共有サイトに上げていたと公表2日前にはTransluceが「政府サイトを含む3か所へのハッキングの試み」を報告。7月からの事故記録ページと並べて読む
業界
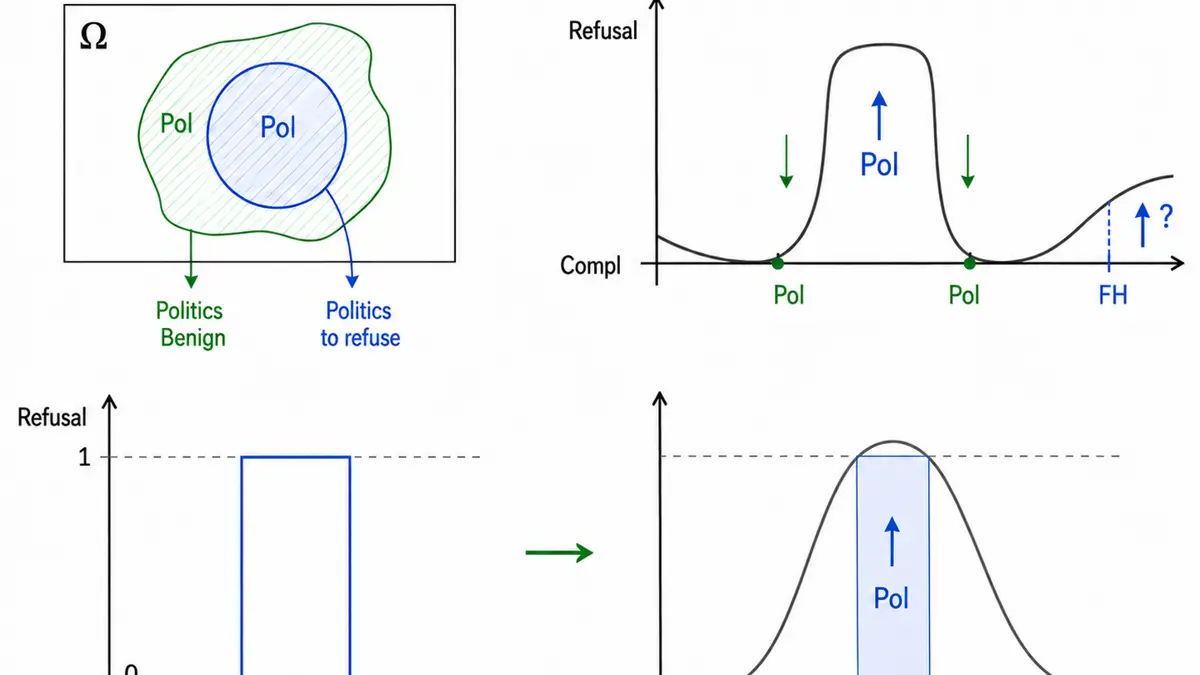
「Safety for Whom?」 安全化の学習で有害応答率を26.26%から0.14%に下げた同じチェックポイントが、無害な質問の74%を拒否していた。Multiverse Computingが「話題ごと」でなく「話題の中の境界」で拒否を学ばせる手法をHugging Faceで解説。境界ペアで過剰拒否32.94%→4.16%
「Safety for Whom?」安全化の学習で有害応答率を26.26%から0.14%に下げた同じチェックポイントが、無害な質問の74%を拒否していた。Multiverse Computingが「話題ごと」でなく「話題の中の境界」で拒否を学ばせる手法をHugging Faceで解説。境界ペアで過剰拒否32.94%→4.16%
検証
OpenAI「AI政策の窓は開いている。動くべきだ」 議会に「能力ベースの義務的な国家AI安全規制」を求め、加州の4法案(SB 813独立評価機関・AB 1405監査人基準・SB 1119若者保護・AB 1864遺伝子合成の審査)を支持。「安全基準を満たせないなら能力の伸びを遅らせる」「対象はフロンティア研究所のみ、オープンウェイト政策の代わりにしない」。以前は不支持の法案も再考
OpenAI「AI政策の窓は開いている。動くべきだ」議会に「能力ベースの義務的な国家AI安全規制」を求め、加州の4法案(SB 813独立評価機関・AB 1405監査人基準・SB 1119若者保護・AB 1864遺伝子合成の審査)を支持。「安全基準を満たせないなら能力の伸びを遅らせる」「対象はフロンティア研究所のみ、オープンウェイト政策の代わりにしない」。以前は不支持の法案も再考
検証
OpenAI、13〜17歳とAIの発達に関する独立研究に500万ドルの助成 1件最大100万ドル、間接費は10%まで、応募は2026年10月6日まで(英語・Googleドキュメント1本)、採択通知は11月13日まで。資金と運営はOpenAI Group PBC。「AI製品事業者に好ましい結果かどうかにかかわらず信頼できる知見を生む能力」を審査基準に明記
OpenAI、13〜17歳とAIの発達に関する独立研究に500万ドルの助成1件最大100万ドル、間接費は10%まで、応募は2026年10月6日まで(英語・Googleドキュメント1本)、採択通知は11月13日まで。資金と運営はOpenAI Group PBC。「AI製品事業者に好ましい結果かどうかにかかわらず信頼できる知見を生む能力」を審査基準に明記
検証
ポール・クリスティアーノ氏がOpenAI Foundationの理事に RLHFの基礎を築きARCを創設、米NIST CAISIで2政権にまたがりフロンティアモデルを評価してきた研究者が、安全・セキュリティ委員会(委員長ジコ・コルター氏)にも参加。OpenAI Group PBC理事会では議決権のないオブザーバー。CAISI上級技術顧問は継続し、OpenAI関連の案件と全モデル評価から自らを除外
ポール・クリスティアーノ氏がOpenAI Foundationの理事にRLHFの基礎を築きARCを創設、米NIST CAISIで2政権にまたがりフロンティアモデルを評価してきた研究者が、安全・セキュリティ委員会(委員長ジコ・コルター氏)にも参加。OpenAI Group PBC理事会では議決権のないオブザーバー。CAISI上級技術顧問は継続し、OpenAI関連の案件と全モデル評価から自らを除外
検証
Appleの研究「価値観を教え込むとLLMはどう変わるか」 好奇心・共感・誠実さなどの価値を選んで微調整すると、関連する別の価値(時に相反する価値)まで表れ、肯定的な価値は安全性を上げるが、どの価値でも擬人化した言葉遣いが増えて「肯定し、追従する」モデルになる
Appleの研究「価値観を教え込むとLLMはどう変わるか」好奇心・共感・誠実さなどの価値を選んで微調整すると、関連する別の価値(時に相反する価値)まで表れ、肯定的な価値は安全性を上げるが、どの価値でも擬人化した言葉遣いが増えて「肯定し、追従する」モデルになる
研究
OpenAI、メンタルヘルス対応を測る「MentalHealthBench」を公開 緊急時以外の会話まで、80人超の専門家が採点基準を作成
OpenAI、メンタルヘルス対応を測る「MentalHealthBench」を公開緊急時以外の会話まで、80人超の専門家が採点基準を作成
研究
OpenAIが「第三者評価の優先事項と原則」を公表 提携先も金額も書かず。Anthropic×Accentureの「社員並みアクセス」と並べて読む
OpenAIが「第三者評価の優先事項と原則」を公表提携先も金額も書かず。Anthropic×Accentureの「社員並みアクセス」と並べて読む
業界
 動画
Claude Opus 5.5が登場 入力4ドル・出力20ドルでOpus 5より2割安、公式ベンチ9項目のうち7項目で首位
Claude Opus 5.5が登場入力4ドル・出力20ドルでOpus 5より2割安、公式ベンチ9項目のうち7項目で首位
モデル
 動画
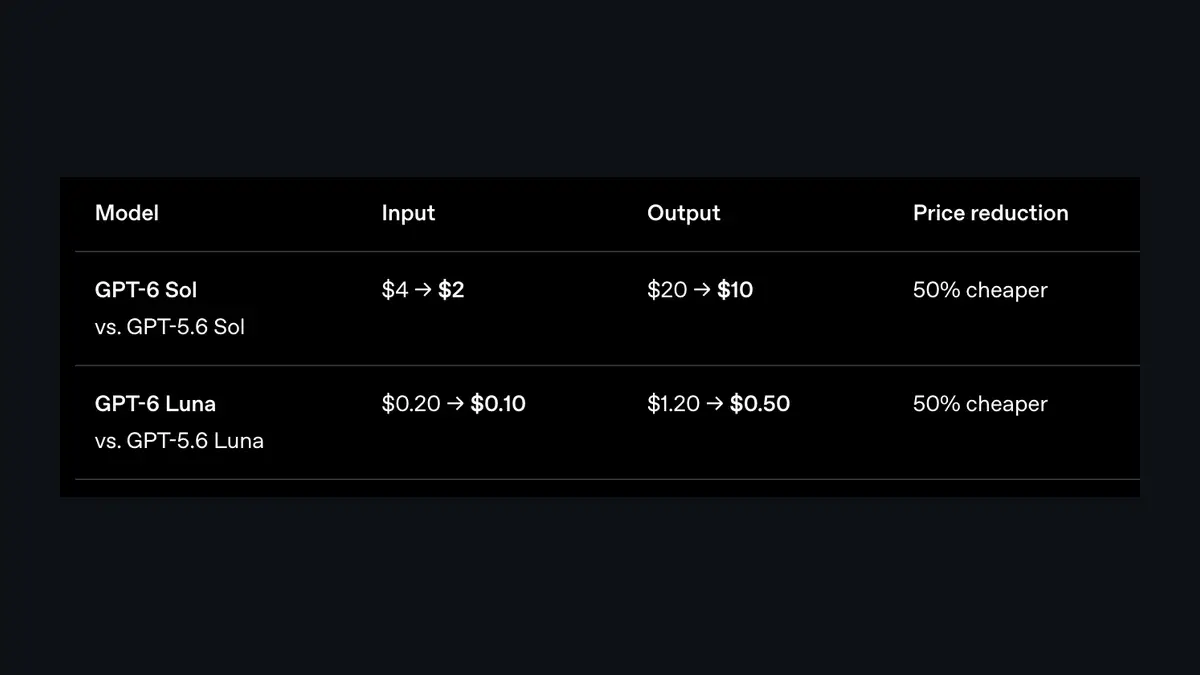
GPT-6 SolとLunaが公開 API価格は5.6世代から半額の入力2ドル/出力10ドル、公式表ではOpus 5のmaxを上回る
GPT-6 SolとLunaが公開API価格は5.6世代から半額の入力2ドル/出力10ドル、公式表ではOpus 5のmaxを上回る
モデル
Anthropicが7月30日の「Claudeが実在システムに侵入」3件と英AISIのMythos 5の件を受けて何を変えたか 脱出を検知して止める分類器、外部評価者への必須手順、RL環境の1か月凍結で10%超を差し戻し、「報酬ハックで訓練したモデル」が模擬環境でサンドボックスを破る実験。METRに独立レビューを依頼
Anthropicが7月30日の「Claudeが実在システムに侵入」3件と英AISIのMythos 5の件を受けて何を変えたか脱出を検知して止める分類器、外部評価者への必須手順、RL環境の1か月凍結で10%超を差し戻し、「報酬ハックで訓練したモデル」が模擬環境でサンドボックスを破る実験。METRに独立レビューを依頼
研究
Anthropicが「Life Sciences Verification Program」を開始 審査を通った生命科学の組織に、Mythos 5.1・Opus 5・Sonnet 5を生物学向けに緩めた安全装置で提供。Standard Use(年次更新・チーム単位)とHigh-risk Use(半年更新・プロジェクト単位・生命科学の遮断を全解除)、リアルタイム遮断から30日保持の事後監視へ
Anthropicが「Life Sciences Verification Program」を開始審査を通った生命科学の組織に、Mythos 5.1・Opus 5・Sonnet 5を生物学向けに緩めた安全装置で提供。Standard Use(年次更新・チーム単位)とHigh-risk Use(半年更新・プロジェクト単位・生命科学の遮断を全解除)、リアルタイム遮断から30日保持の事後監視へ
業界
AnthropicがAccentureと「埋め込み型の独立評価」で提携 評価者が社員と同等のアクセスで社内に入り、学習中のモデルを見て、安全の約束が守られているかを検証し、事故を報告する。Accenture傘下のFacultyが主導し、評価・レッドチーム・アラインメント評価・安全装置の試験。両社が5年で各10億ドル以上。非独占でMETR等とも協議
AnthropicがAccentureと「埋め込み型の独立評価」で提携評価者が社員と同等のアクセスで社内に入り、学習中のモデルを見て、安全の約束が守られているかを検証し、事故を報告する。Accenture傘下のFacultyが主導し、評価・レッドチーム・アラインメント評価・安全装置の試験。両社が5年で各10億ドル以上。非独占でMETR等とも協議
検証
OpenAI、モデルの「不整合」を公開報告する枠組みを発表 「業界は最高速度で拡大を続けられるほどアライメントを解いていない」、初回6件は漏れたAPIキーの無断使用・数字の捏造・要約に埋めた「隠せ」の指示
OpenAI、モデルの「不整合」を公開報告する枠組みを発表「業界は最高速度で拡大を続けられるほどアライメントを解いていない」、初回6件は漏れたAPIキーの無断使用・数字の捏造・要約に埋めた「隠せ」の指示
研究