大規模言語モデル(LLM)の記事
「大規模言語モデル(LLM)」に関連するAIニュースと解説を、出典付きで103本まとめています。
大規模言語モデル(LLM) の記事:103件
検証09.07読了13分
手元のメモリを99.998%まで使い切る量子化ツール「shoehorn」──プリセットGGUFをやめる発想
出典 ─ make any language model fit your machine
研究09.07読了13分
GEPAを飲み込んだ最適化基盤「synth-optimizers」──ホスト専用の探索アルゴリズム「GELO」を覗く
出典 ─ synth-laboratories/opt
研究09.06読了24分
Skillsが効くのは「知識を足すから」ではなく「手順の道しるべになるから」──8,135件のトライアルが示した実態
出典 ─ Demystifying Agent Ski
研究09.06読了10分
DSPyの裏側で動く最適化エンジン「GEPA」──強化学習より少ない試行でプロンプトを進化させる仕組みを読む
出典 ─ gepa-ai/gepa README(Gi
検証09.06読了10分
プロンプトを「使い捨てる」のをやめる──個人開発者Huzzahが提案する疑似コードエディタ
出典 ─ Huzzah
モデル09.06読了10分
Metaが「Muse Glimmer」を公開──Muse Sparkを30Bに蒸留、Apache 2.0でローカル実行専用
出典 ─ huggingface/transforme
研究09.06読了15分
モデルの起動待ち時間を2.38倍短縮──SGLangが「CUDAグラフのキャプチャ中にチェックポイントを読み込む」設計に変えた
出典 ─ sgl-project/sglang v0.
研究09.06読了16分
モデルを変えずにTerminal-Bench 2.1で95.3%──「ハーネス側だけ」を作り込んだStateMの実験費用は15ドル
出典 ─ StateM: Reaching 95.3%
研究09.06読了17分
SWE-bench Verifiedの未解決問題、6割はテスト自体に欠陥があった──7言語・170件のリファクタリングで最高スコアは41.2%
出典 ─ SWE-Bench ProMax: Benc
研究09.06読了16分
正解ラベルなしで自分を鍛え直す──U-OPSDはモデルの多数決だけを教師にして数学ベンチマークを8.5〜10.7%押し上げた
出典 ─ On-Policy Self-Distill
研究09.06読了10分
vLLMのDecode Context Parallelで、Kimi-K3のKVキャッシュ容量がGPU1台あたり10倍に
出典 ─ vllm-project/vllm v0.2
研究09.06読了10分
vLLMに投機的デコードの新手法「DFlash2」──1H200・GSM8Kで自己回帰の3.51倍のスループット
出典 ─ vllm-project/vllm v0.2
プロダクト09.06読了11分
コピーを持たない「最初の公開AI」──wildstaticの実験Staticに接続すると、お金が尽きていて誰とも話せなかった
出典 ─ The First Public AI
研究09.05読了11分
LLMが書いたGPUカーネルの「正解率」は本当か──12ゲート検証器が2,638件を洗い直すと4割近くが壊れていた
出典 ─ A Contract-Grade Verifier for LLM-Generated GPU Kernels, and a Native Blackwell Backward for the Gated-Linear-Recurrence Family
業界09.05読了11分
『AIをそのまま貼るな』を掲げるdontpastetheai.comが、HNで581件の議論を呼んだ理由
出典 ─ dontpastetheai.com
モデル09.05読了13分
Kimiのmoonshot-v1シリーズが8月31日で終了──呼ぶと404、公式一覧で終了履歴をたどる
出典 ─ Kimi API Platform 公式ドキュメント
検証09.05読了11分
MCP Python SDK v2安定版──FastMCPがMCPServerに、サーバーはクライアントを呼べなくなった代わりに何が変わったか
出典 ─ modelcontextprotocol/p
モデル09.05読了12分
1文字ずつでなく面で書くAI──商用スケールの拡散言語モデルMercuryとは
出典 ─ Introducing Mercury, t
研究09.05読了11分
OpenID Connectの『name』『given_name』クレームがCWTにやってくる──SPICE WGのOIDC-CWTを読む
出典 ─ IETF Datatracker「draft
研究09.05読了12分
AIモデルに『改ざんされていない証明』を付ける──OpenSSF Model Signing (OMS)の署名フォーマットを読む
出典 ─ GitHub: ossf/model-sig
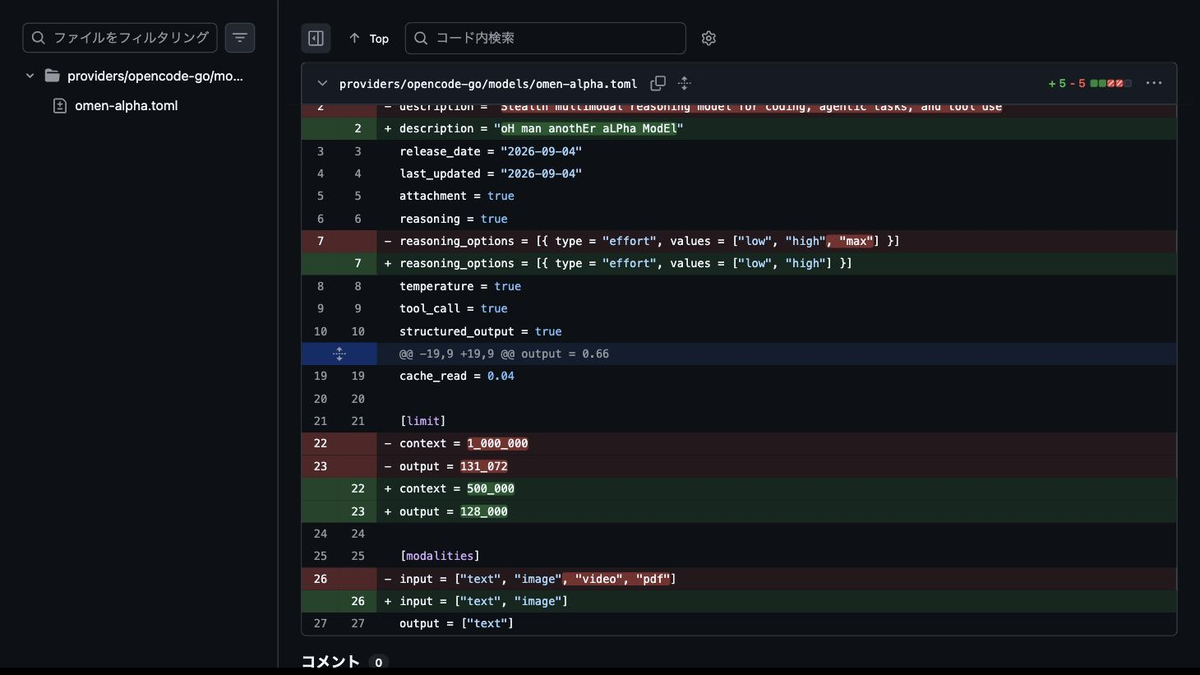
モデル09.04読了13分
覆面AI「Omen Alpha」を課金して測った──公開スペックは実物より小さく、トークナイザはGLMと18対18で一致
出典 ─ OpenCode公式X「Omen Alpha
研究09.04読了12分
エージェントのシステムプロンプトをハッシュ化して身元にする──Agentic JWTの『エージェントチェックサム』を読む
出典 ─ IETF Datatracker「draft
業界09.04読了12分
中国政府がAI企業を含む「网信企業」を格付け育成へ──2030年までの行動計画
出典 ─ 中国网信网「促进网信企业高质量发展行动计划(
研究09.04読了12分
強化学習環境を「作り直さず、着せ替える」──EnvHarnessは静的な訓練環境をラップして弱点を突く
出典 ─ EnvHarness: Awakening
新しい記事をメールで受け取る
AIの新しい発表を、公式資料にあたって数字を確認したうえで届けます。盛らない・出典を明記する・確認できていないことは書かない、を守ります。