DeepSeek(ディープシーク)、V4.1-Flashの更新版「DeepSeek-V4.1-Flash-1017」をMITライセンスで公開Terminal-Bench 4.0は31.2から42.3、表の11項目すべてで旧版を上回る(同社掲載の数字)
日刊AIニュース10月17日(土)号:前日のAIのニュース17本を短くまとめました(約8分)›
DeepSeekは2026年10月17日、V4.1-Flashの更新版「DeepSeek-V4.1-Flash-1017」をHugging FaceでMITライセンスのオープンウェイトとして公開した。同社のモデルカードでは、Terminal-Bench 4.0が31.2から42.3、HLE(ツールなし)が36.8から42.6に上がり、表の11項目すべてで旧版を上回る。
目次
DeepSeek(ディープシーク)は2026年10月17日(協定世界時)、V4.1-Flashの更新版「DeepSeek-V4.1-Flash-1017」をHugging Faceで公開しました。モデルの重みはMITライセンスのオープンウェイトです。モデルカードは今回の更新を「minor update(小さな更新)」と呼び、推論、コーディング、エージェント、画像系のベンチマークが上がったほか、タスクの実行時間と出力の長さも減ったと説明しています。Hugging Faceのメタデータでは、リポジトリの作成は協定世界時10月17日2時40分(日本時間11時40分)です。
3行まとめ
- DeepSeekが「DeepSeek-V4.1-Flash-1017」をMITライセンスのオープンウェイトで公開。コンテキストは1Mトークン
- 同社の表では、Terminal-Bench 4.0が31.2から42.3、HLE(ツールなし)が36.8から42.6など、11項目すべてで旧V4.1-Flashを上回る
- DeepSeekのAPIの更新履歴によると、公式のWeb・アプリも1017版に更新済み。APIはモデル名deepseek-flashのまま、料金も据え置き
本記事の内容は、日本時間10月17日17時台に公式ページで確認したものです。17時35分に、DeepSeekのAPIの更新履歴と料金ページを追加で確認して書き足しました。
何が変わったのか:旧版との差を表で見る
モデルカードの比較表から、DeepSeek-V4.1-Flash-1017(以下、1017版)と旧V4.1-Flashの数字を抜き出しました。いずれもDeepSeekが自社のページに載せた値です。
| ベンチマーク | 1017版 | 旧V4.1-Flash | 差 |
|---|---|---|---|
| HLE(ツールなし) | 42.6 | 36.8 | +5.8 |
| Terminal-Bench 4.0 | 42.3 | 31.2 | +11.1 |
| DeepSWE v1.1 | 77.0 | 74.2 | +2.8 |
| ProgramBench | 29.1 | 20.3 | +8.8 |
| NL2Repo-Bench | 68.2 | 65.4 | +2.8 |
| Automation-Bench v1.0.6 | 60.5 | 54.8 | +5.7 |
| Agents' Last Exam | 35.4 | 31.8 | +3.6 |
| Apex Bench v1.1 | 72.1 | 64.6 | +7.5 |
| Chartography(ツールあり) | 83.0 | 78.9 | +4.1 |
| BabyVision(ツールあり) | 92.5 | 89.6 | +2.9 |
| ZeroBench-main(ツールあり) | 51.0 | 49.0 | +2.0 |
「差」の列は、表の2つの数字から本記事で引き算したものです。HLEには括弧つきの数字(1017版44.0、旧版39.1)も併記されており、これは「HLEのテキストのみの部分集合」だとモデルカードに注記があります。上の表には括弧なしの数字を使いました。
最も差が大きいのはTerminal-Bench 4.0の+11.1です。1017版のモデルカードの注記によると、この項目はClaude Codeのハーネスで測っています。DeepSWE v1.1はMini-SWE-V2のハーネスです。ただし、旧V4.1-Flashのモデルカードは、同じ31.2という数字を「DeepSeek HarnessのMinimal mode」で測った値と説明しています。旧版の31.2を1017版と同じハーネスで測り直したのかどうかは、1017版のページには書かれていません。
他社モデルと並べるとどうか
同じ表には、K3、GLM-5.3、GPT-5.6 Sol、Opus 5の数字も並んでいます。1017版を基準に、表の範囲で言えることは次のとおりです。
- 比較対象の中で1017版が最も高いのは、DeepSWE v1.1(77.0)、Automation-Bench v1.0.6(60.5)、Agents' Last Exam(35.4)、Apex Bench v1.1(72.1)の4項目です
- Opus 5が上回る項目も多く、HLE(56.3)、Terminal-Bench 4.0(51.8)、ProgramBench(37.0)、NL2Repo-Bench(75.3)、Chartography(84.0)、BabyVision(94.1)がそうです
- ZeroBench-mainは、GPT-5.6 Sol(53.0)とOpus 5(52.0)が1017版の51.0を上回っています
総じて、DeepSeek自身の表でも「全項目で他社モデルを超えた」という内容ではなく、旧版からの底上げとエージェント系の複数項目での高い数字、という形です。比較対象の数字をDeepSeekがどう測ったかは、今回確認したページでは詳しく書かれていません。
どうやって動かすのか
モデルカードによると、推奨のサンプリング設定は次のとおりです。
| 項目 | 値 |
|---|---|
| temperature | 1.0 |
| top_p | 1.0 |
| context_window | 1Mトークン |
| max_tokens | 256K以上 |
プロンプトの組み立てには注意点があります。モデルカードは「このリリースにはJinja形式のチャットテンプレートを含まない」と書いています。代わりに、encodingフォルダーにPythonの参照実装(encoding.py)があり、複数ターンの会話、ツール呼び出し、思考モード、数値で指定する推論の強さ、会話途中のシステムメッセージ、画像の混在に対するテストケースが付いています。
本番向けには、別にRustのライブラリ群「deepseek-recipe」をMITライセンスで公開しています。GitHubのREADMEによると、Messages、Chat Completions、Responsesの各形式のリクエストをConversation形式に直し、DeepSeek V4とV4.1のプロンプトまたはトークンIDに変換し、モデルの出力を応答に戻す部品です。Pythonバインディングもあり、python3 -m pip install deepseek-recipeで入ります。推論そのもの、ツールの実行、HTTP通信は呼び出す側が用意する設計です。READMEは、未対応の機能として、logprobs、音声・動画の入力、web_searchなどサーバー側のツール実行、JSON Schemaや正規表現による出力制約、n > 1の複数回答なども挙げています。
手元で動かす場合は、推論フォルダーのREADMEに手順があります。Hugging Face形式の重みを、テンソル並列のランクごとに1ファイルへ変換してから実行する流れです。READMEの例では並列数を8(MP=8)とし、変換時に--expert-dtype fp4を指定しています。READMEはこの実装を「読みやすい参照実装であり、本番用の推論エンジンではない」と位置づけています。
規模とライセンス
Hugging Faceのメタデータでは、1017版のSafetensorsのパラメータ数は合計763B(約7,632億)、ファイルの総サイズは約510GBです。形式はBF16、F32、F8_E4M3、I8が混在しています。ライセンスは、モデルカードに「リポジトリとモデルの重みはMITライセンス」と書かれています。
アーキテクチャの説明は、旧V4.1-Flashのモデルカードにあります。1017版のモデルカードはそれらを書き直しておらず、引用表記も旧版のtech report「DeepSeek-V4.1-Flash: Pushing the Limits of KV Cache Compression」のままです。旧版の説明では、画像とテキストを扱うマルチモーダルのMoEモデルで、バックボーンは552B、コンテキストは最大100万トークンです。プリフィル時に8B、デコード時に16Bのパラメータだけを動かし、グローバルなKVキャッシュは1トークンあたり890バイト(前世代のDeepSeek-V4-Flashの約1/4)とあります。これらが1017版にそのまま当てはまるかは、1017版のページ自体には書かれていません。「小さな更新」という説明からは同じ土台と読めますが、本記事では推測にとどめます。
日本の読者が気にする点
今回確認した範囲で、日本向けの記載は次のとおりです。
- 日本語の対応:4つの公式ページ(1017版のモデルカード、旧版のモデルカード、推論README、deepseek-recipeのページ)に、日本語の性能を示す数字は見当たりませんでした。上の表のベンチマークも、日本語を対象にしたものか、モデルカードからはわかりません
- API・アプリ:DeepSeekのAPIの更新履歴は「公式のWebとアプリのモデルも新しい版に更新した」と書いています。当サイトのDeepSeekのログイン方法の記事で紹介している公式の入口から、1017版を使えることになります。APIは呼び出し方も料金も変わらず、モデル名
deepseek-flashで1017版につながります。旧名のdeepseek-v4-flashとdeepseek-v4-flash-vision-expも受け付けますが、中身は1017版で、Flashの料金がかかると料金ページに注記があります - API料金と時間帯:料金ページの
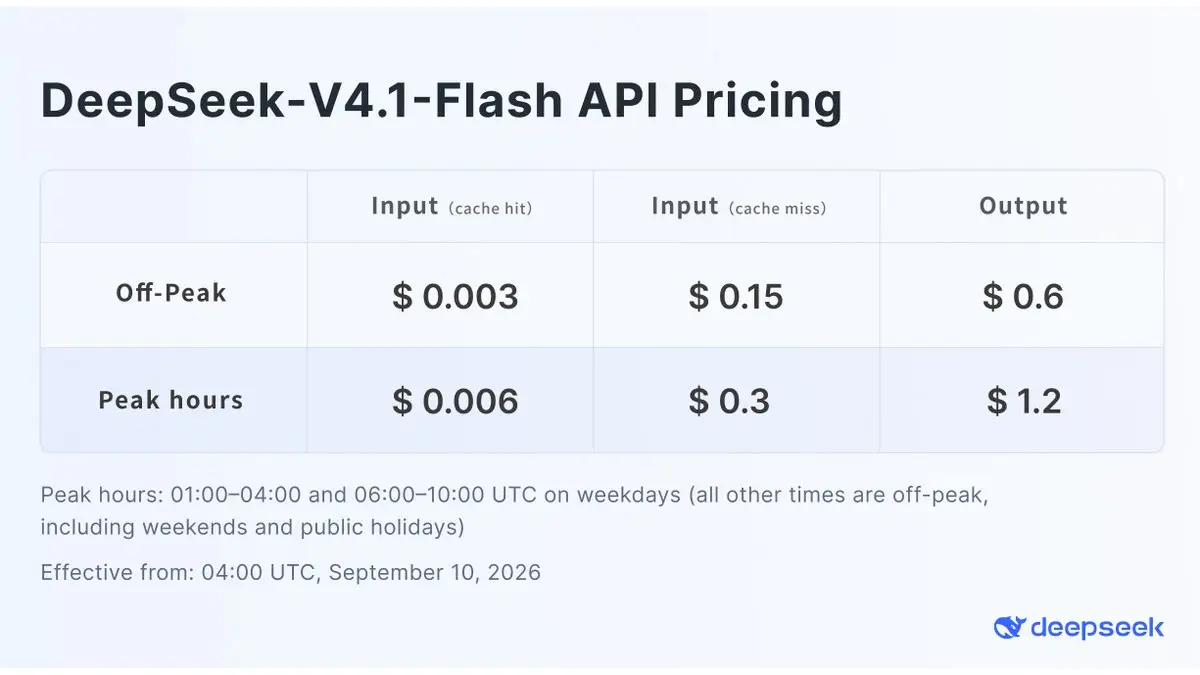
deepseek-flashは、100万トークンあたり入力0.15ドル(キャッシュに当たれば0.003ドル)、出力0.6ドルです。これは混雑しない時間帯の値で、混雑する時間帯は倍の入力0.3ドル(同0.006ドル)、出力1.2ドルです。混雑する時間帯は、中国の祝日を除く平日の協定世界時1時〜4時と6時〜10時、日本時間でいえば平日の10時〜13時と15時〜19時です。コンテキストは1Mトークン、出力は最大384Kトークンです - 旧版の提供状況:旧V4.1-Flashのページには、novita、fireworks-ai、featherless-ai、deepinfra、basetenが推論プロバイダーとして並んでいました。1017版のページには「This model isn't deployed by any Inference Provider」と表示されていました
サービスとしてのDeepSeekの性質(データの保存先など)は、DeepSeekとは何かの記事にまとめています。オープンウェイトを自分の環境で動かす場合とは話が別です。
公式ページを見て気づいたこと
日本時間17時7分にモデルのページを取得した時点で、ダウンロード数は「0」、いいねは「1」でした。推論READMEのコミットには「about 2 hours ago」と出ており、公開から数時間という段階です。一方、旧V4.1-Flashのページは、いいねが4,570件台、ダウンロード数は直近1か月で約128万回と表示されていました(旧版の作成日は2026年9月10日)。コミュニティタブの議論も、1017版は0件、旧版は73件です。公開直後のため、今回確認したページには、実際に動かした人の報告はまだありません。
まだ確かめられていないこと
- 表の数字はすべてDeepSeekのモデルカードとAPIの更新履歴によるもので、第三者による再現は確認していません。APIの更新履歴には、ZeroBench-mainはPass@5(5回答えさせて1回でも正解なら正解)で測ったという注記もあります。ハーネスの設定によっても数字は動くため、他社の発表値と単純に比べるのは注意が必要です。上で触れたとおり、Terminal-Bench 4.0は新旧のモデルカードでハーネスの説明が異なります
- 「実行時間と出力の長さが減った」という説明に対応する数字(トークン数や所要時間)は、モデルカードの表には載っていませんでした。Pareto frontier(性能とコストの最適な組み合わせ)を押し上げたという主張も、同じく数字では示されていません
- 1017版固有のtech reportは、今回確認した範囲には見当たりません。モデルカード上部の「Technical Report」のリンク先は、旧版のPDFでした
- APIの更新履歴は、DeepSeek Harness、TencentのCodeBuddyとWorkBuddyなどに向けて特に調整したとし、DeepSeek Harnessは0.2.1-rc.1以降への更新を勧めています。調整の中身は書かれていません
- 筆者は1017版を実際に動かしていません。本記事はすべて公式ページの記載にもとづきます
出典と確認時刻
- deepseek-ai/DeepSeek-V4.1-Flash-1017(Hugging Face):日本時間2026年10月17日17時7分に確認
- deepseek-ai/DeepSeek-V4.1-Flash(Hugging Face):同17時7分に確認(旧版の数字とアーキテクチャの説明)
- inference/README.md(Hugging Face):同17時7分に確認
- deepseek-ai/deepseek-recipe(GitHub):同17時7分に確認
- Change Log(DeepSeek API Docs):同17時35分に確認(Web・アプリ・APIへの反映)
- Models & Pricing(DeepSeek API Docs):同17時35分に確認(料金と時間帯)
本記事は続報があり次第更新します。
この記事でよく聞かれること
- DeepSeek-V4.1-Flash-1017とは何ですか?
- DeepSeekがHugging Faceで公開したオープンウェイトのモデルです。モデルカードは、V4.1-Flashの「minor update(小さな更新)」で、推論・コーディング・エージェント・画像系のベンチマークが上がり、タスクの実行時間と出力の長さが減ったと説明しています。リポジトリの作成は協定世界時2026年10月17日2時40分(日本時間11時40分)です。
- ライセンスは何ですか?商用で使えますか?
- モデルカードには、リポジトリとモデルの重みはMITライセンスと書かれています。商用利用の可否について、モデルカードは個別に説明していません。実際に使う前にリポジトリ内のLICENSEファイルを確認してください。
- 旧版のV4.1-Flashから、どのくらい数字が上がりましたか?
- DeepSeekがモデルカードに載せた表では、掲載された11項目すべてで旧版を上回っています。たとえばTerminal-Bench 4.0は31.2から42.3、HLE(ツールなし)は36.8から42.6、ProgramBenchは20.3から29.1です。数字はいずれもDeepSeek自身の掲載値で、第三者の再現は確認していません。
- DeepSeekのAPIやチャットアプリでもすぐ使えますか?
- 使えます。DeepSeekのAPIの更新履歴(Change Log)は、公式のWebとアプリのモデルも1017版に更新したと書いています。APIは呼び出し方も料金も変わらず、モデル名deepseek-flashのまま1017版になります。料金ページでも、deepseek-flashのモデルのバージョンはDeepSeek-V4.1-Flash-1017です。一方、Hugging Face上の推論プロバイダー経由の提供は、日本時間17時35分の時点でありませんでした。
出典・参照資料
- 一次資料deepseek-ai/DeepSeek-V4.1-Flash-1017 — Hugging Face(DeepSeek公式) ↗
- 一次資料deepseek-ai/DeepSeek-V4.1-Flash — Hugging Face(DeepSeek公式) ↗
- 一次資料inference/README.md — DeepSeek-V4.1-Flash-1017(DeepSeek公式) ↗
- 一次資料deepseek-ai/deepseek-recipe — GitHub(DeepSeek公式) ↗
- 一次資料Change Log — DeepSeek API Docs(DeepSeek公式) ↗
- 一次資料Models & Pricing — DeepSeek API Docs(DeepSeek公式) ↗
この記事の解説動画
YouTubeで見る ↗
大きいニュースはYouTubeでも解説しています。Xでは新着記事をお知らせしています。
コメント
まだコメントはありません。最初のコメントを書いてみませんか?
AIについて聞きたいことはありますか?
質問箱で無料で受け付けています。回答は公開され、他の方の参考にもなります。
質問箱を見る →関連記事
Reflection(リフレクション)、初のオープンモデル Beam(ビーム)を公開 総パラメータ501B・アクティブ23B・文脈100万トークンをApache 2.0で、SWE-bench Verified 81.6%は同社提供の数字
Reflection(リフレクション)、初のオープンモデル Beam(ビーム)を公開総パラメータ501B・アクティブ23B・文脈100万トークンをApache 2.0で、SWE-bench Verified 81.6%は同社提供の数字
Liquid AI(リキッドAI)、アクティブ2Bの推論モデル「LFM2.5-24B-A2B」をオープンウェイトで公開 LiveClawは48.09でQwen3.6-35B-A3Bの38.19を上回る(同社測定)
Liquid AI(リキッドAI)、アクティブ2Bの推論モデル「LFM2.5-24B-A2B」をオープンウェイトで公開LiveClawは48.09でQwen3.6-35B-A3Bの38.19を上回る(同社測定)
DeepSeek-V4.1-Flash公開 出力100万トークン0.6ドル、KVキャッシュは1トークン890バイト
DeepSeek-V4.1-Flash公開出力100万トークン0.6ドル、KVキャッシュは1トークン890バイト
IBM「Granite 4.2」の作り方 初の推論特化の密なモデル3B・8B・30B(Apache 2.0、日本語を含む12言語)。SFTの31.6%がエージェント軌跡(Codex・Gemini CLI等のハーネスで生成)、RLはRLVR→SWE→端末→検索→RLHFの階段で8B・30Bだけ実環境のエージェントRL。30BはSWE-Bench Verified 57.00
IBM「Granite 4.2」の作り方初の推論特化の密なモデル3B・8B・30B(Apache 2.0、日本語を含む12言語)。SFTの31.6%がエージェント軌跡(Codex・Gemini CLI等のハーネスで生成)、RLはRLVR→SWE→端末→検索→RLHFの階段で8B・30Bだけ実環境のエージェントRL。30BはSWE-Bench Verified 57.00
Tencent(テンセント)、AIの長期記憶の「書き込み」専用モデルHy-Memory-30B-A3BをHugging Faceで公開 4つの枠組みの平均55.49でClaude Opus 5の54.62を上回ると同社測定
Tencent(テンセント)、AIの長期記憶の「書き込み」専用モデルHy-Memory-30B-A3BをHugging Faceで公開4つの枠組みの平均55.49でClaude Opus 5の54.62を上回ると同社測定
IBM、チャット・判定・音声認識を1つのエンドポイントで扱う「Granite Switch 4.1(グラナイト スイッチ)」を公開 8Bと30B、VRAMは基本モデルとほぼ同じと説明
IBM、チャット・判定・音声認識を1つのエンドポイントで扱う「Granite Switch 4.1(グラナイト スイッチ)」を公開8Bと30B、VRAMは基本モデルとほぼ同じと説明
 動画
Meta「Muse Spark Open(ミューズ スパーク オープン)」公開 公式の表で米国製のInkling・Nemotronを上回り、Kimi K3には20項目中8項目で上回る、Mac Studio 2台で動く
Meta「Muse Spark Open(ミューズ スパーク オープン)」公開公式の表で米国製のInkling・Nemotronを上回り、Kimi K3には20項目中8項目で上回る、Mac Studio 2台で動く