Raspberry Pi 5でGemma 4 E2Bをオフライン実行LiteRT-LMでプリフィル99トークン/秒・デコード9トークン/秒・ピークメモリ1,432MB、生成は約300語/分(人の会話の2倍)。GPUにYOLOの物体検出を逃がし、CPUでMoonshineの音声認識・Gemma・TTSを回すReachy Miniロボットの構成。pip install litert-cliで開始
日刊AIニュース11月7日(土)号:前日のAIのニュース3本を短くまとめました(約5分)›
GoogleとRaspberry Pi Ltd・Igaliaのエンジニアは2026年8月11日、Raspberry Pi 5でLiteRTとGemmaを使い、クラウドに依存しないエッジAIを組む手順を公開した。Gemmaの選択肢はGemma 3 270M・EmbeddingGemma 300M・Gemma 3 1B・Gemma 4 E2B・Gemma 4 E4B。Pi 5のCPUでLiteRT-LMがGemma 4 E2Bを動かすとプリフィル99トークン/秒・デコード9トークン/秒・ピークメモリ1,432MBで、約27.3文字/秒、約300語/分。GPUのVideoCore VIIはCPUより非力だが、WebGPU(Vulkan)経由のML Driftで視覚・音声モデルをGPUに逃がしCPUをLLMに残す。Reachy Miniのデモは、YOLOをGPU、Moonshineの音声認識・Gemma 4 E2B・TTSをCPUで並列に回す。LiteRT CLI(pip install litert-cli)で変換・量子化・ベンチ・推論を一括。
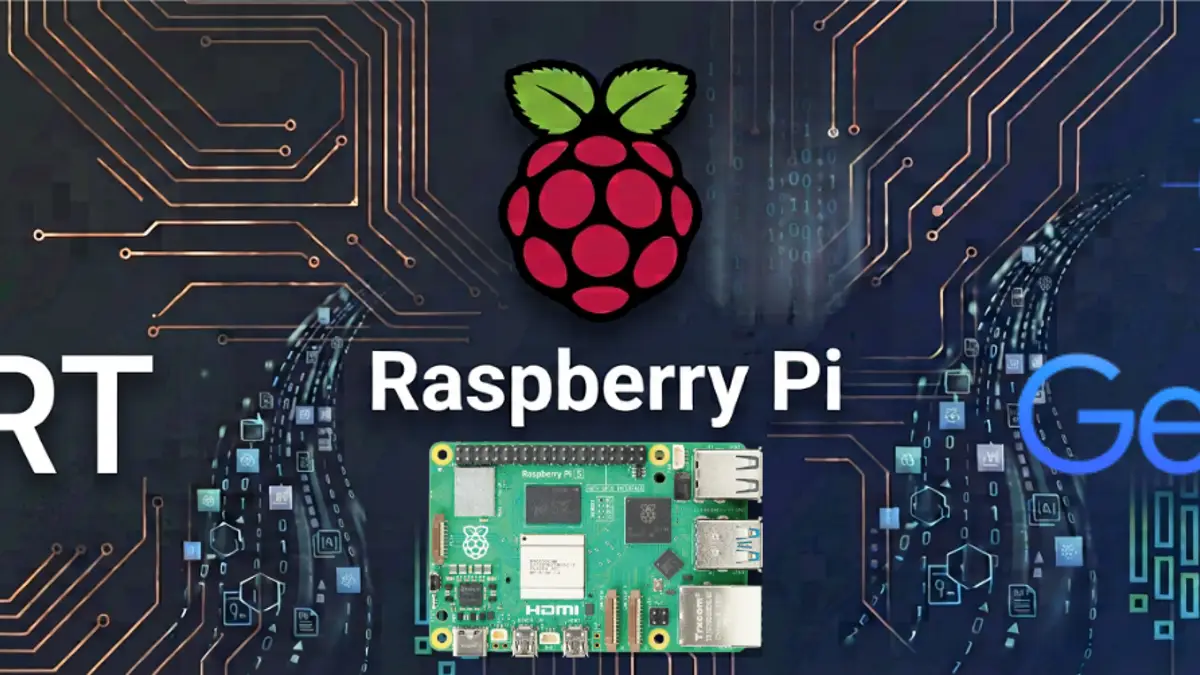
2026年9月18日・日本時間時点の情報です。 Google Developersのブログ(8月11日)を読んだ。当サイトはRaspberry Piで動くオフラインの車載エージェントやローカルLLMの音声対話の実現性を扱ったが、Google公式の「Pi 5でGemmaを何トークン/秒で回せるか」の数字は書いていなかった。
3行まとめ
- どのGemmaを選ぶか。 記事はPi向けに5つを並べる。Gemma 3 270M(微調整前提の超小型。感情分析や抽出)、EmbeddingGemma 300M(端末内の埋め込み。RAG・検索・分類)、Gemma 3 1B(多言語のテキスト専用。要約・作文)、Gemma 4 E2B(メモリマップされた層別埋め込みで、RAM節約が最優先の常時監視・音声処理向け)、Gemma 4 E4B(推論力と大きさの均衡点。複数段の計画)。
- 数字。 Pi 5のCPUで、LiteRTの上のオーケストレーション層LiteRT-LM(XNNPACKでCPU加速)がGemma 4 E2Bをプリフィル99トークン/秒・デコード9トークン/秒・ピークメモリ1,432MBで動かす。E2Bのトークナイザは1トークン約4.2文字と効率がよく、Reachy Miniの音声デモでは約27.3文字/秒=約300語/分の生成で、人の会話(約150語/分)の2倍。GPU側は、CPU(Cortex-A76×4、約153.6 GFLOPS FP32/約2.0 TOPS INT8)に対しVideoCore VII(800MHz、約76.8 GFLOPS/約0.24 TOPS)と非力だが、LiteRTのWebGPU(Vulkan)バックエンド(ML Drift)で視覚・音声・埋め込みモデル(MediaPipe・Ultralytics YOLO・Moonshine等)をGPUに逃がし、CPUをLLMと全体の制御に残す異種並列の設計を勧める。
- Reachy Miniの構成とツール。 Pollen RoboticsのロボットReachy Miniのデモは、①カメラ映像のYOLO物体検出をGPUで常時、②発話の音声認識(Moonshine)をCPU、③Gemma 4 E2B(CPU)が書き起こしと最新の視覚メタデータから返答と身振りをストリーミング生成、④TTS(CPU)が音声にして返す、の4系統を並列に回す。開発はLiteRT CLI(
pip install litert-cli)で変換・量子化・ベンチマーク・推論を1つのコマンド群にまとめ、LiteRT CLIのスキルをAntigravity等のコーディングエージェントに入れると、オフラインの音声翻訳機(Gemma Translator)のような多段の作業をエージェントに任せられる。IoT向けにバイナリの配布サイズも小さいとする(比較表は画像)。
遅い秒間トークンが速く感じる理由
- 「デコード9トークン/秒」は文章生成としては遅い部類だが、E2Bのトークナイザが1トークンに多くの文字を詰めるため、体感の文字数は人の話速を上回る、という説明。日本語での文字/トークン比は本文にない
- GPUが「CPUより弱い」と明記したうえで、負荷の分離(熱と優先度)のために使う、という整理は、当サイトの車載エージェントでも同じ悩みがあった
- ロボット側の記事として読むと、ADK for Kotlinの端末内エージェントがAndroid、こちらがLinux SBC、と住み分けている
- ベンチマークはGoogle側の測定で、温度や電源による変動は書かれていない
原文の数字は確認、実機未検証
この記事の下調べで、筆者は9月18日にGoogle Developersのブログを取得し、5モデルの説明・99/9トークン/秒・1,432MB・約4.2文字/トークン・約27.3文字/秒・GPUとCPUのFLOPS・Reachy Miniの4系統・CLIのインストール手順がその原文にあることを確認した。GitHubのサンプルは開いていない。筆者はRaspberry Pi 5でLiteRTを動かしていない。
E4Bの数字・日本語効率・電力は未記載
- Gemma 4 E4Bの速度とメモリ
- 日本語でのトークン効率
- 消費電力と発熱
出典:Raspberry Pi向け技術記事
- Mastering Edge AI on Raspberry Pi with LiteRT and Gemma(Google Developers・2026年8月11日)
関連記事
出典・参照資料
大きいニュースはYouTubeでも解説しています。Xでは新着記事をお知らせしています。
コメント
まだコメントはありません。最初のコメントを書いてみませんか?
AIについて聞きたいことはありますか?
質問箱で無料で受け付けています。回答は公開され、他の方の参考にもなります。
質問箱を見る →関連記事
車をチャットルームの一員にする Raspberry Pi 5に35BのQwenを載せて完全オフラインで動かすCarWatch
車をチャットルームの一員にするRaspberry Pi 5に35BのQwenを載せて完全オフラインで動かすCarWatch
ローカルLLMは音声対話に向かないのか 「1〜2秒」の壁をハードウェアごとに検証する
ローカルLLMは音声対話に向かないのか「1〜2秒」の壁をハードウェアごとに検証する
Google「ADK for Kotlin 1.0」が正式版 Python版・Java版のADK 1.0と同じ機能に加え、Android向けの端末内エージェント(LiteRT-LM・ML Kitベータ)、Firebase AI Logicのハイブリッド、RoomとAppSearchで状態の保存。@Toolと@Paramでスキーマを自動生成、SKILL.mdで手順を段階的に読む
Google「ADK for Kotlin 1.0」が正式版Python版・Java版のADK 1.0と同じ機能に加え、Android向けの端末内エージェント(LiteRT-LM・ML Kitベータ)、Firebase AI Logicのハイブリッド、RoomとAppSearchで状態の保存。@Toolと@Paramでスキーマを自動生成、SKILL.mdで手順を段階的に読む
オンデバイスAIとは iPhoneのApple IntelligenceとAndroidのGemini Nano、仕組みの違い
オンデバイスAIとはiPhoneのApple IntelligenceとAndroidのGemini Nano、仕組みの違い
LM Studio(エルエムスタジオ)は日本語で使える 画面の言語は設定で選べ、無料で何ができるか・始め方・Bionicの料金【2026年10月版】
LM Studio(エルエムスタジオ)は日本語で使える画面の言語は設定で選べ、無料で何ができるか・始め方・Bionicの料金【2026年10月版】
Google「LiteRT.js」 .tfliteモデルをブラウザで動かすJavaScript版LiteRT。TensorFlow.jsのJSカーネルでなくネイティブのランタイムをWebAssemblyで提供し、CPU(XNNPACK)・GPU(WebGPU)・NPU(WebNN)を使い分け。他のWebランタイム比で最大3倍、CPU比でGPU/NPUは5〜60倍
Google「LiteRT.js」.tfliteモデルをブラウザで動かすJavaScript版LiteRT。TensorFlow.jsのJSカーネルでなくネイティブのランタイムをWebAssemblyで提供し、CPU(XNNPACK)・GPU(WebGPU)・NPU(WebNN)を使い分け。他のWebランタイム比で最大3倍、CPU比でGPU/NPUは5〜60倍
NVIDIA、IFA 2026でローカルAIの4本 Hermes Agent・OpenClaw・Perplexity Portable Computerがワンクリックでローカルモデル設定、llama.cppはRTX 5090で最大1.9倍、家庭内の遊休PCに推論を振り分ける無料OSS「PAIR」(Apple M4以降も)、10月にRTX Spark搭載Windows PC
NVIDIA、IFA 2026でローカルAIの4本Hermes Agent・OpenClaw・Perplexity Portable Computerがワンクリックでローカルモデル設定、llama.cppはRTX 5090で最大1.9倍、家庭内の遊休PCに推論を振り分ける無料OSS「PAIR」(Apple M4以降も)、10月にRTX Spark搭載Windows PC